A 2021-ben kriptobányászatra kiadott NVIDIA CMP 170HX (8 GB) ugyanarra a GA100-as lapkára épül, mint az adatközponti A100, és fizikailag 80 GB HBM2e memóriát hordoz, amelynek gyárilag csak a tizede érhető el. Egy Kate nevű kutató 2026. november 10-én a blogján és a GA100VFI GitHub-repójában bemutatott feszültséghibás eljárással tíz megvizsgált 8 GB-os kártyából kilencen aktiválta a teljes 80 GB VRAM-ot. A mai videokártya-árak mellett – amikor egy 32 GB-os RTX 5090 ára is millió forint fölött jár – egy használtan jóval olcsóbb 80 GB-os gyorsító komoly figyelmet kap a helyi AI-közösségben.
Tíz kártyából kilencnél működött a teljes 80 GB
A lapkagyártásban megszokott válogatás (binning) miatt az NVIDIA a GA100-as csipek egy részét letiltott blokkokkal és szigorú digitális biztosítékokkal (eFuse-okkal) bocsátotta ki bányászkártyaként: az öt HBM2e-torony összesen 80 GB kapacitásából csak 8 GB maradt aktív, a számítási tömbök (SM-ek) számát pedig 70-re korlátozták. Korábban a szoftveres cmpunlocker már elérte a 64 GB memóriát és a PCIe Gen2 sebességet, de a gyári biztosítéklánc átírását egy védelmi bit megakadályozta.
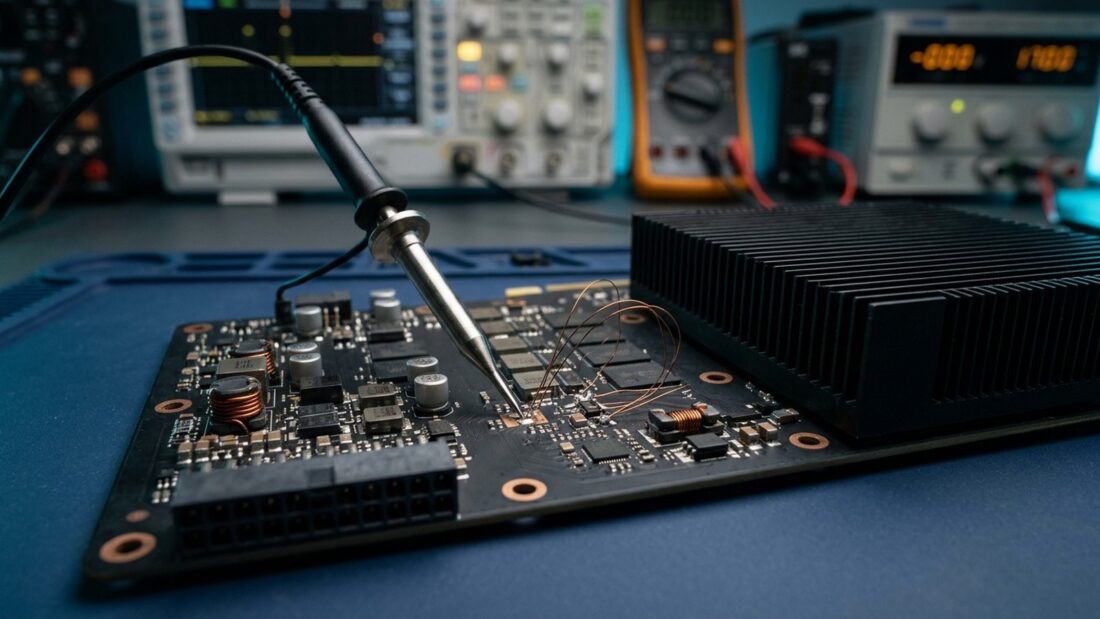
Kate hardveres módszere ezt a védelmi ellenőrzést kerüli meg a chip tápellátásának indításkori, ezredmásodperces megzavarásával (voltage fault injection, röviden VFI): a kártya tápvezérlőjére kötött mikrokontrolleres áramkörrel – amelynek tervezésében a GPT-6 Astra is segített – felülírhatóvá válnak a letiltott memória- és számítási blokkok. A ComputerBase által is idézett tízdarabos mintában kilenc kártyán gond nélkül működött a teljes 80 GB memória szintetikus teszteken, valamint valós vLLM és SGLang nyelvimodell-futtatás közben is; a tizedik példány valódi hardverhiba miatt maradt 64 GB-on.
Kate saját mérése: +18,4% OpenCL FP16 FMA-ban
Mivel a kiskereskedelmi A100-asokon a biztos gyártási hozam érdekében 108 SM aktív, a hibamentesebb bányászlapkákon viszont gyakran 120–126 ép SM található, Kate egyik feloldott példányán 124 SM (7936 mag) dolgozott egyszerre. A kutató konkrét OpenCL FP16 FMA mérésében ez a példány 85,858 TFLOP/s teljesítményt hozott a bolti A100 72,488 TFLOP/s eredményével szemben – ez ebben az egy tesztben 18,4 százalékos előnyt jelent, ami nem általánosítható automatikusan minden AI- vagy CUDA-terhelésre. A PCIe Gen4 x16 sávszélesség és két kártya között az NVLink is aktiválható további hardveres beavatkozással.
| Állapot (Kate mérése) | VRAM | Aktív SM | OpenCL FP16 FMA / csatoló |
|---|---|---|---|
| Gyári 170HX | 8 GB HBM2e | 70 SM | Korlátozott, PCIe Gen2 |
| cmpunlocker | 64 GB HBM2e | Korlátozott | PCIe Gen2 plafon |
| Bolti A100 | 80 GB HBM2e | 108 SM | 72,488 TFLOP/s, PCIe Gen4 |
| GA100VFI mod | 80 GB HBM2e (9/10) | 120–126 SM (mért: 124) | 85,858 TFLOP/s (+18,4%), Gen4 x16 |
Gyakorlati korlátok a mindennapokban
A módszer kifejezetten haladó barkácsolóknak szól: finom nyáki forrasztást, külső mikrokontrollert és kártyánként akár 1–48 órás hangolást igényel, a passzív szerverhűtés miatt erős légáramlás kell hozzá, az NVLink-modnál pedig külön tápegységek használata kockázatos lehet. A 2020-as GA100 energiahatékonysága sem mérhető a mai gyorsítókéhoz, mégis látványos ellenpélda egy olyan piacon, ahol egy új, 32 GB-os professzionális kártya is 1799 euróba kerül.