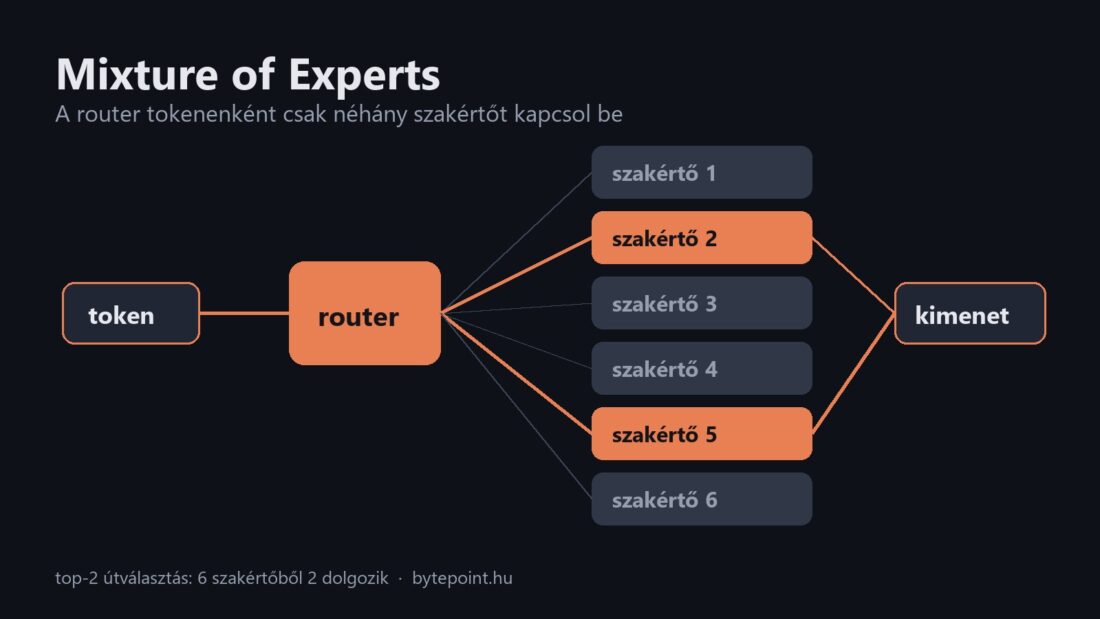
Mixture of Experts (MoE, magyarul nagyjából „szakértők keveréke”): ezen az architektúrán fut többek között a Mixtral és a DeepSeek-V3. A lényege, hogy a modell rengeteg paraméterrel rendelkezik, de egy-egy szó (pontosabban token) feldolgozásához ezeknek csak a töredékét használja. Hogy melyik részét, azt egy kis beépített hálózat, a router dönti el. Ebben a magyarázóban végigvesszük, hogyan működik ez a döntés, milyen módszerek vannak rá, és miért fontos, ha valaki MoE-modellt futtatna a saját gépén.
Sűrű és ritka modellek: mi az a szakértő?
Egy hagyományos, úgynevezett sűrű (dense) nyelvi modell minden tokennél az összes paraméterét használja. A transzformer-modellek minden rétegében van egy előrecsatolt hálózat (feed-forward network, FFN), ez végzi a számítások jelentős részét. Az MoE-modell ezt az egy blokkot több, párhuzamos példányra cseréli: ezek a szakértők (experts). Minden tokennél csak néhány szakértő dolgozik, a többi pihen. Ezért hívják ezeket ritka (sparse) modelleknek.
Egy hasonlattal: a sűrű modell olyan, mint egy kórház, ahol minden beteget az összes orvos megvizsgál. Az MoE-modellben van egy recepció, amely minden beteget csak ahhoz a két-három orvoshoz küld, akinél a legtöbb értelmét látja. Így a kórháznak lehet sokkal több orvosa, mégsem tart tovább egy vizsgálat.
Az ötlet régi, a gyakorlatban viszont sokáig nehéz volt működésre bírni. A Google kutatói, Noam Shazeer és társai 2017-es tanulmányukban akár több ezer szakértőből álló MoE-réteget építettek, és egy 137 milliárd paraméteres modellt tanítottak vele. A szerzők szerint a modellek kapacitását több mint ezerszeresére tudták növelni, miközben a számítási hatékonyság csak kicsit romlott.
A router: hogyan dől el, ki dolgozzon?
A router egy kis tanítható hálózat, amely minden tokenhez minden szakértőre kiszámol egy pontszámot: mennyire illik az adott szakértő ehhez a tokenhez. A legmagasabb pontszámú k darab szakértő kapja meg a tokent, ez a top-k útválasztás. A kiválasztott szakértők eredményét a router a pontszámokkal súlyozva összeadja, ez lesz a réteg kimenete. A router is a tanítás során tanulja meg, kit mikor válasszon, ugyanúgy, ahogy a modell többi része.
Top-1 vagy top-2? A Switch Transformer és a Mixtral
Sokáig az volt az elfogadott nézet, hogy legalább két szakértőre van szükség tokenenként, hogy a router jól tanuljon. A Google 2021-es Switch Transformer tanulmánya ezzel szemben egyetlen szakértőt választott (k = 1). A szerzők szerint ez megőrizte a modell minőségét, csökkentette a router számítási és kommunikációs költségét, és egybillió paraméteres modellek tanítását is lehetővé tette. A T5 modellekre épülő változataik azonos számítási kapacitással akár hétszer gyorsabban tanultak.
A Mistral AI 2024-es Mixtral 8x7B modellje a top-2 módszert használja: minden rétegben 8 szakértő van, és a router tokenenként kettőt választ ki. Így a modell összesen 47 milliárd paraméterrel rendelkezik, de egy token feldolgozásánál csak 13 milliárd aktív. A Mistral szerint a Mixtral az összes mért teszten utolérte vagy megelőzte a Llama 2 70B-t és a GPT-3.5-öt.
A legnagyobb gond: a terheléselosztás
Ha a routert magára hagyják, hajlamos mindig ugyanazt a néhány szakértőt választani. Ezek egyre jobbak lesznek, ezért még többször választja őket, a többi szakértő pedig alig tanul. Ezt hívják routing collapse-nak, vagyis az útválasztás összeomlásának. Ráadásul a nagy modelleknél a szakértők különböző GPU-kon futnak, így ha mindenki ugyanahhoz megy, az egyik kártya túlterhelődik, a többi üresjáratban vár.
A klasszikus megoldás két elemből áll. Az egyik a kapacitásfaktor (capacity factor): minden szakértő legfeljebb egy előre megszabott mennyiségű tokent fogadhat. Ami efölött érkezik, az túlcsordul, és a Switch Transformerben kihagyja ezt a réteget. A másik egy kiegészítő veszteségfüggvény (auxiliary loss), amely a tanítás során „bünteti” a modellt, ha egyenetlenül osztja el a tokeneket. Ennek viszont ára van: a DeepSeek-V3 kutatói szerint ha ez a büntetés túl erős, rontja a modell teljesítményét.
Fordított logika: amikor a szakértő választ tokent
A Google 2022-es Expert Choice módszere megfordítja a kérdést. Nem a token választ szakértőt, hanem minden szakértő kiválasztja magának a számára legjobban illő k darab tokent. Így minden szakértő pontosan ugyanannyi munkát kap, a terhelés eleve kiegyenlített. Egy token közben változó számú szakértőhöz kerülhet: egy fontos tokennel több is foglalkozhat, egy egyszerűvel akár egy sem. A szerzők szerint azonos számítási kapacitás mellett a tanítás több mint kétszer gyorsabban konvergált, mint a Switch Transformer top-1 és a GShard top-2 módszerével.
Sigmoid és eltolás: így csinálja a DeepSeek-V3
A DeepSeek-V3 összesen 671 milliárd paraméteres, de tokenenként csak 37 milliárd aktív. Minden MoE-rétegében egy közös (shared) szakértő van, amely minden tokent feldolgoz, mellette pedig 256 útválasztott szakértő, amelyekből a router tokenenként 8-at választ. Két újítást is bevezetett. A pontszámokat a megszokott softmax helyett sigmoid függvénnyel számolja, így minden szakértő pontszáma a többitől függetlenül 0 és 1 közé esik. A terheléselosztáshoz pedig nem büntető veszteségfüggvényt használ, hanem minden szakértőhöz egy eltolást (bias). Ha egy szakértő túlterhelt, az eltolását csökkentik, ha alulterhelt, növelik. Az eltolás csak abba szól bele, hogy kit választ a router, a szakértő kimenetének súlyát nem módosítja. A kutatók szerint ez a módszer a legtöbb teszten jobb eredményt adott, mint a csak kiegészítő veszteséget használó változatok.
| Modell / módszer | Év | Útválasztás | Összes / aktív paraméter |
|---|---|---|---|
| Shazeer et al. (sparsely-gated MoE) | 2017 | tanítható kapuhálózat, top-k | legfeljebb 137 milliárd (MoE-réteg) |
| Switch Transformer | 2021 | top-1, kapacitásfaktor, kiegészítő veszteség | legfeljebb kb. 1 billió |
| Expert Choice | 2022 | a szakértők választanak tokent | – |
| Mixtral 8x7B | 2024 | top-2 a 8 szakértőből | 47 milliárd / 13 milliárd |
| DeepSeek-V3 | 2024 | sigmoid, top-8 a 256-ból + 1 közös szakértő, eltolásos terheléselosztás | 671 milliárd / 37 milliárd |
Tényleg „szakértők” a szakértők?
A név megtévesztő lehet. Kézenfekvő lenne azt gondolni, hogy van egy matekos, egy biológus és egy programozó szakértő, de a Mixtral fejlesztői ezt megvizsgálták, és nem így találták. A tanulmány szerint a szakértők kiválasztása nagyon hasonló volt tudományos cikkeknél, biológiai szövegeknél és filozófiai írásoknál is. A szakértők inkább a nyelvtani szerkezethez igazodtak, mint a témához, különösen az első és az utolsó rétegekben. A szakértők tehát nem emberi értelemben vett szakterületek, hanem a tanítás során kialakult, nehezen értelmezhető munkamegosztás.
Mit jelent ez, ha otthon futtatnál egy MoE-modellt?
Az aktív paraméterszám határozza meg, mennyi számítás kell egy tokenhez, ezért egy MoE-modell gyorsabban generál, mint egy azonos összméretű sűrű modell. A memóriaigényt viszont az összes paraméter szabja meg: a modell minden szakértőjének betöltve kell lennie, hiszen nem lehet előre tudni, melyiket választja a router. Egy 47 milliárd paraméteres Mixtral ezért nagyjából egy 13 milliárdos modell tempójával számol, de egy 47 milliárdos modell memóriáját igényli. Jó példa erre az Aleph Alpha Kolibri modellje is: 78,1 milliárd paraméteréből tokenenként csak 3,46 milliárd dolgozik. A DeepSeek újabb modelljeiről, például a V4 Flash-ről is írtunk.