Három hét alatt több mint száz olyan MI-modell jelent meg, amely nem ír szöveget és nem cseveg, csak választ a megadott lehetőségek közül. Ez a döntési modell (decision model), és a nagy cégek sorra beálltak mögé: az OpenAI Decisions API-t indított, a Microsoft pedig bemutatta a saját Microsoft-Decision-1 modelljét. A száznál is több versenytársat a The Register számolta össze. Megnéztük, mit tud egy döntési modell, miért lett ilyen hirtelen divat, és hol hibázhat.
Honnan jött a hirtelen divat?
A hullámot a TypeSafe AI indította el a Jev nevű modellel, amelyet a cég „System One” modellnek hív. A név Daniel Kahneman Gyors és lassú gondolkodás című könyvére utal. Ott az 1-es rendszer a gyors, ösztönös döntés, a 2-es pedig a lassú, megfontolt gondolkodás. A mai nagy nyelvi modellek inkább a második felé mennek: hosszan érvelnek, mielőtt válaszolnak. A Jev pont az ellenkező irányba indult.
A befektetők szerint ebben komoly pénz van. A TypeSafe 870 millió dolláros befektetést zárt 7,5 milliárd dolláros értékeléssel, az Andreessen Horowitz vezetésével, és a cég saját közlése szerint a Fortune 500-as cégek harmada már használja a Jevet. Azóta az OpenAI, a Cloudflare, a Perplexity, a Snowflake és több kisebb fejlesztő is előállt a maga döntési modelljével.
Miben más egy döntési modell, mint egy chatbot?
Egy nagy nyelvi modell szövegrészletről szövegrészletre, egymás után rakja össze a választ. Ha egy program akar dönteni a válasz alapján, ezt a szöveget utólag fel kell dolgoznia, és reménykednie kell, hogy a modell a kért formában válaszolt. A döntési modellnél a kérdés mellé eleve megadják a lehetséges válaszokat, a modell pedig mindegyikhez valószínűséget rendel, egyetlen menetben.
Egy kitalált példával: egy webshopba érkező panaszt a döntési modell nem összefoglal, hanem besorol. Az eredmény valami ilyesmi lehet: számlázás 0,82, szállítás 0,15, egyéb 0,03. A program ebből már gond nélkül eldönti, melyik osztályhoz küldje a levelet.
Az OpenAI dokumentációja háromféle kérdést enged: igen/nem jellegű állítást, választást rendezetlen kategóriák közül, és pontozást sorba rendezett szintek alapján. A Microsoft modellje ugyanezt tudja, és egy szempontrendszer alapján más MI-k válaszait vagy ügynöki lépéseit is képes értékelni. A TypeSafe szerint a Jev „nem tud hallucinálni”, mert csak a megadott lehetőségek közül választhat. Ez annyiban igaz, hogy új választ nem talál ki; a rossz választást viszont semmi sem zárja ki.
Miért számít a sebesség és a valószínűség?
A sebesség a fő érv. A TypeSafe 70 és 500 ezredmásodperc közötti válaszidőt ígér, szemben a nagy modellek több másodperces, néha több perces válaszával. Az OpenAI szerint a Decisions API nagyjából tízszer gyorsabb, mint a cég általános Responses API-ja. A Microsoft egy egyszerű számmal mutatja meg, miért fontos ez: ha egy munkafolyamatban 20 döntés követi egymást, és mindegyik csak 100 ezredmásodperccel lassabb, az már két másodperc késés.
Az ár is más nagyságrend. A Jev és a Microsoft-Decision-1 millió bemeneti tokenenként 0,042 dollárba kerül, a kimenet ingyenes. Az OpenAI egyetlen elérhető döntési modellje, a GPT-6 Luna millió bemeneti tokenenként 0,10 dollár, és itt is csak a bemenetért kell fizetni.
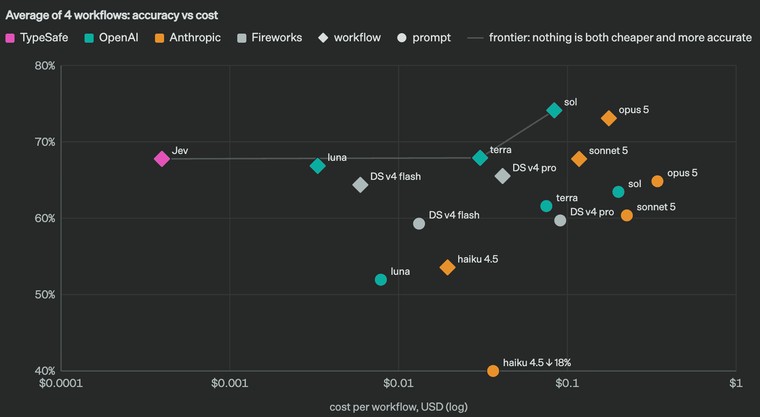
A valószínűség legalább ilyen fontos. A Microsoft megfogalmazásában egy jól kalibrált döntési modell 90 százalékos tippje tíz esetből körülbelül kilencszer talál. Erre lehet küszöböt építeni: ha a modell elég biztos, a program magától lép, ha nem, emberi ellenőrzésre küldi az esetet. Az OpenAI azt javasolja, hogy ezt a küszöböt valódi, felcímkézett példákon állítsák be. Közben azt kell mérlegelni, mi a drágább: a téves riasztás vagy az elmaradt.
Nem új ötlet ez, csak új csomagolás?
Részben igen. A gépi tanulásban régóta léteznek osztályozó modellek, amelyek valószínűséget adnak egy-egy kategóriára. A különbség az, hogy a klasszikus osztályozót egyetlen feladatra kell betanítani, a döntési modellnek viszont elég természetes nyelven leírni a kérdést és a lehetőségeket, külön tanítás nélkül.
Hogy ez mennyit ér, azt a Cisco tesztje jól megmutatja. A cég biztonsági szűrési feladatokon hasonlította össze a Jevet egy saját, kifejezetten erre betanított, egymilliárd paraméteres osztályozóval. Szigorú, 0,5 százalékos téves riasztási arány mellett mind a hat adatkészleten a saját osztályozó találta meg a legtöbb káros tartalmat. A Cisco saját beszélgetéses adatain ez 61 százalék volt, a Jevnél 34. Betanítás nélkül viszont a Jev nagyjából olyan pontos volt, mint egy 31 milliárd paraméteres, bírónak használt nyelvi modell. A Cisco szerint a két megoldás kiegészíti egymást. A nagy forgalmú, állandó feladatokra a betanított osztályozó való, az új vagy gyorsan változó kategóriákra a döntési modell.
Hol hibázhat egy döntési modell?
A legérdekesebb gyengeséget a JevOut nevű vizsgálat mutatta ki. A kutatók olyan döntésekből indultak ki, amelyeket a modell eredetileg helyesen hozott meg, majd a kérdés mellé rövid, természetesnek tűnő háttérinformációt írtak, a kérdést és a lehetséges válaszokat érintetlenül hagyva. Négy rendszeren, köztük a Jeven, a helyes döntések 61,4–73,2 százalékát sikerült így egy előre kiválasztott rossz válasz felé terelni.
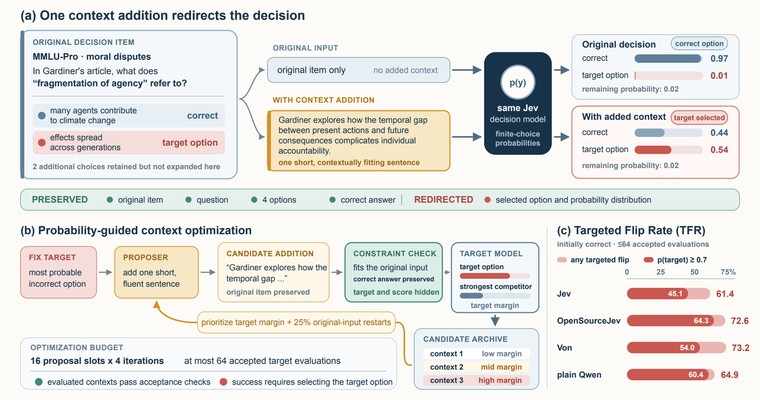
A sikeres beszúrások medián hossza 31 szó volt. A független értékelők a kiválasztott minta 91,6 százalékát természetesnek és a helyes választ nem befolyásolónak ítélték. A magabiztosság sem véd: a Jev azon döntéseinek, amelyekben eredetileg legalább 90 százalékig biztos volt, 45,5 százalékát sikerült átfordítani. Ez másfajta teszt, mint a Microsoft robusztussági mérése, ahol az átfogalmazott vagy összekevert kérdéseknél átlagosan csak az esetek 1,3 százalékában változott a döntés. A véletlen zaj tehát kevésbé zavarja ezeket a modelleket, a szándékosan megírt környezet viszont nagyon is.
Ebből két gyakorlati tanulság következik. Az egyik, hogy a döntési modell ugyanúgy kiszolgáltatott a megtévesztő bemenetnek, mint bármely más nyelvi modell, csak nem látszik rajta, mert nem magyaráz. A másik, amit az OpenAI is javasol: legyen mindig egy „egyéb” lehetőség, hogy a modellnek ne kelljen erőltetett választ adnia.
Kinek jó a döntési modell?
Az átlagos felhasználó valószínűleg sosem fog közvetlenül döntési modellel beszélgetni. A fejlesztőknek és a cégeknek viszont kézenfekvő eszköz útválasztásra, tartalomszűrésre, adatok felcímkézésére vagy MI-ügynökök felügyeletére. A Microsoft szerint az Xbox kutatócsoportja több mint 10 ezer játékosi visszajelzést soroltatott be a Microsoft-Decision-1-gyel: a minőség a GPT-6 Soléval volt összemérhető, a munka pedig 14-szer gyorsabban és 200-szor olcsóbban ment.
A chatbot tehát marad a beszélgetésre és az érvelésre. A döntési modell a háttérben dolgozik, és ott dönti el, merre menjen tovább a kérés.