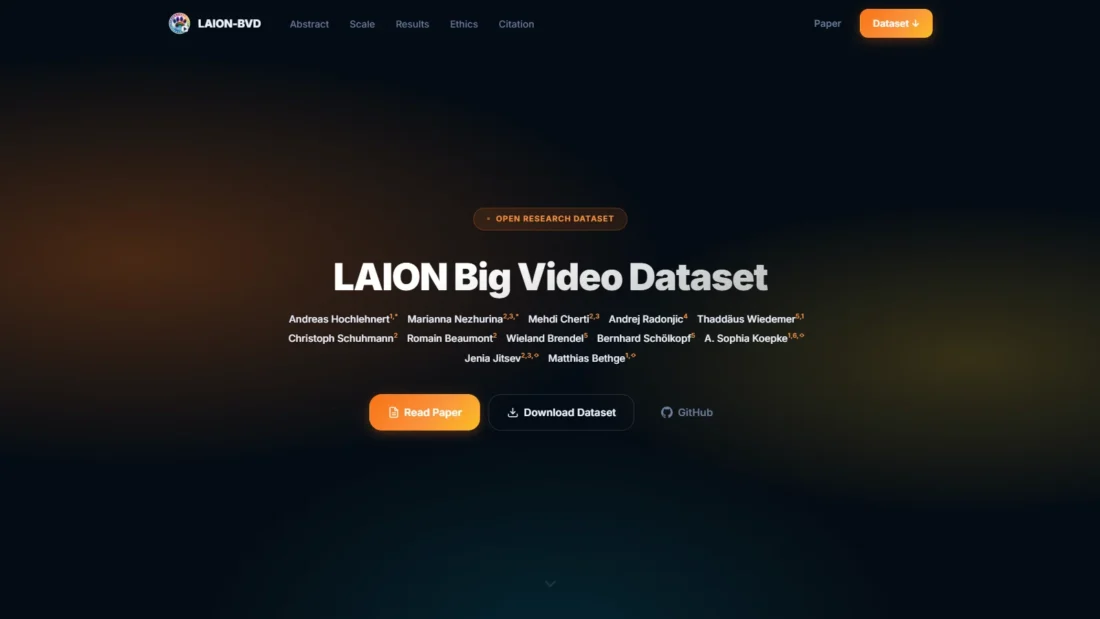
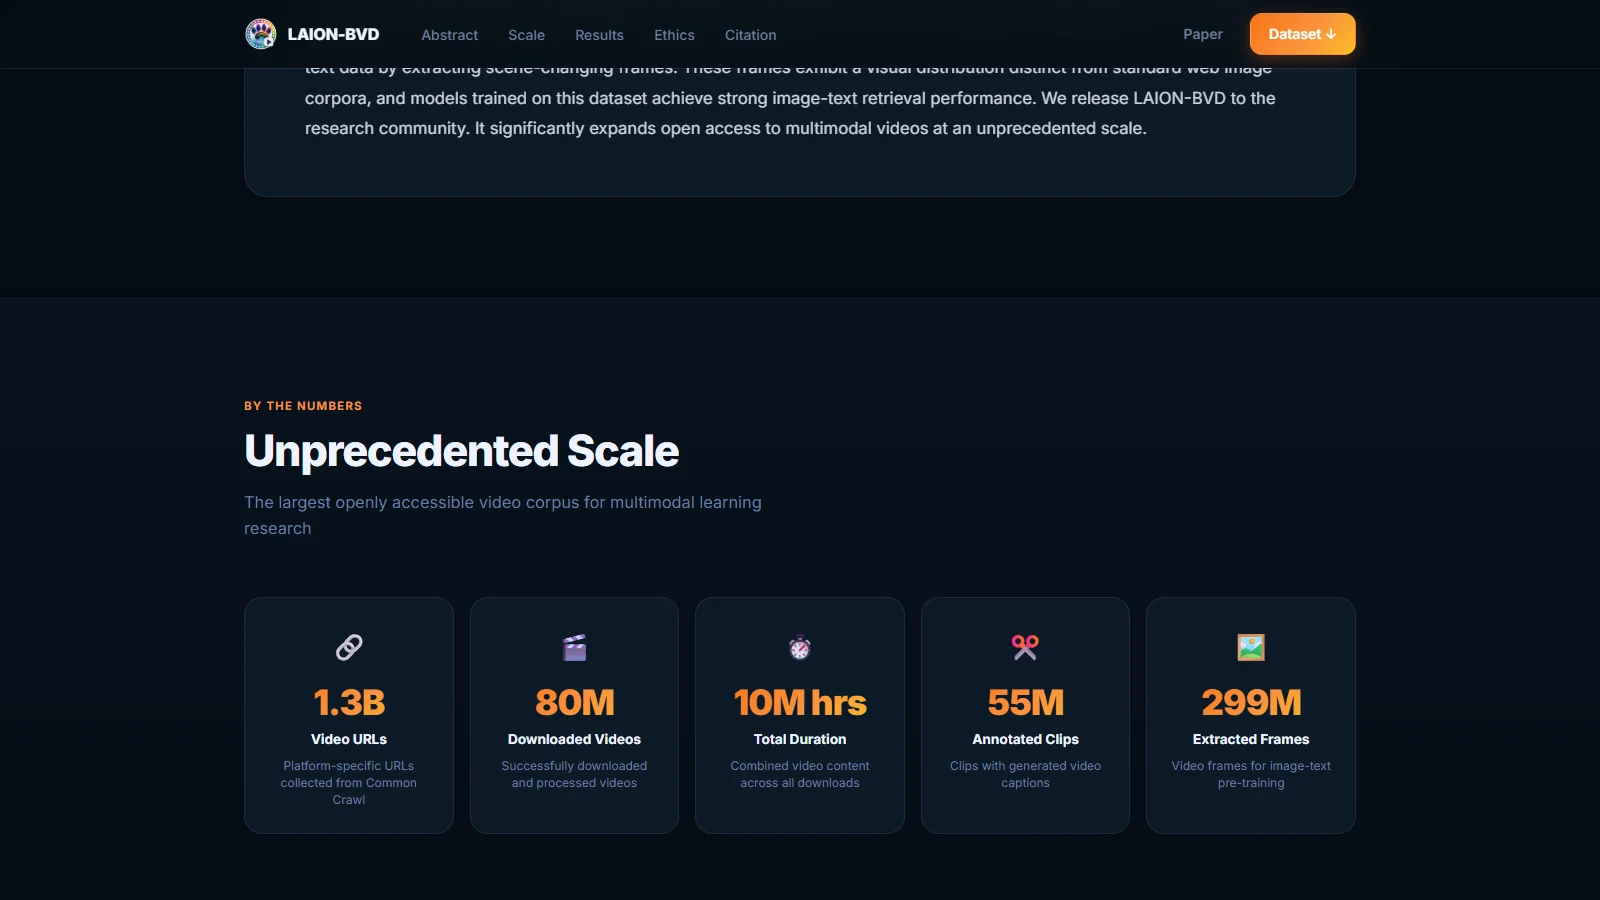
A LAION kutatóközössége egy új, kifejezetten videókra épített nyílt adatkészlettel próbálja kitágítani a multimodális AI-kutatás határait. A LAION Big Video Dataset (LAION-BVD) hivatalos projektoldala szerint a korpuszhoz 1,3 milliárd, Common Crawlból gyűjtött videó-URL vezet, ezek közül mintegy 80 millió videót sikerült ténylegesen letölteni és feldolgozni.
Nem egyetlen videótár, hanem többlépcsős korpusz
A számokat érdemes rétegenként olvasni. Az 1,3 milliárd elsősorban platformokhoz köthető URL, nem ennyi letöltött videót jelent. A feldolgozási láncban körülbelül 80 millió videó maradt meg, összesen nagyjából tízmillió órányi tartalommal. A jelenetek felismerése után a kutatók mintegy 55 millió, automatikusan feliratozott klipet és csaknem 300 millió, jelenetváltásoknál kinyert képkockát számolnak. A hivatalos oldal ezért inkább egymásra épülő adatváltozatként mutatja be a BVD-t, nem egyetlen, változatlan állományként.
Mit csináltak a nyers videókkal?
A pipeline először a Common Crawlban talált hivatkozásokból próbálta letölteni a videókat. Ezután jelenetváltásokat kerestek, hogy a hosszú anyagokat kezelhető klipekre bontsák. A klipekhez szintetikus video- és audiocímkék készültek, a képkockák pedig külön képszöveg-előtanításhoz használhatók. Ez a felépítés azért fontos, mert más feladathoz kell a teljes mozgókép, a rövid jelenet és az egyetlen képkocka is.
A projektoldal és a kapcsolódó arXiv-tanulmány szerint a LAION-BVD-n betanított ViCLIP modell több standard videó–szöveg benchmarkon elérte vagy meghaladta az InternVid eredményeit. A szerzők legfeljebb 2,1 százalékpontos előnyt mértek, amikor 10–50 millió klipből álló mintákkal dolgoztak. Ez a kutatók saját összehasonlítása, nem független laboratóriumi audit, így a szám inkább irányt mutat, mint végleges rangsort.
A nyíltság nem jelent korlátlan felhasználást
A LAION-BVD kutatási célra készült. A letöltési és hozzáférési oldal külön választja a feldolgozott metaadatokat és a nyers videóhozzáférést: a BVD-RAW-hoz kutatási, jellemzően akadémiai és nem kereskedelmi hozzáférési feltételek kapcsolódnak. A készítők arra is figyelmeztetnek, hogy a forrásvideók szerzői jogai, platformfeltételei és a datasetben megjelenő torzítások külön ellenőrzést igényelnek.
Ezért a BVD nem azt jelenti, hogy bárki szabadon letölthet tízmillió órányi videót és bármire felhasználhatja. A lényeg inkább az, hogy a kutatók egy nagyságrenddel nagyobb, nyíltabban vizsgálható videókorpuszhoz kapnak hozzáférést, miközben a jogi és etikai felelősség nem tűnik el a link mögött.
Miért lehet ez fontos?
A videóértéshez nem elég képeket egymás mellé tenni: a modelleknek mozgást, időbeli összefüggéseket és hangot is kell tanulniuk. A LAION-BVD ezt a teljes láncot próbálja nyíltan kezelhetővé tenni, ami kutatási szempontból nagy előrelépés lehet a szűkebb, nehezebben hozzáférhető adatkészletekhez képest. A projekt valódi tesztje most az lesz, hogy a közösség mennyire tudja reprodukálni az eredményeket, és hogyan kezeli a források jogi, minőségi és adatvédelmi problémáit.