Kiadta legújabb, kétnyelvű nagy nyelvi modelljét a heidelbergi központú Aleph Alpha: a Kolibri névre keresztelt architektúra 78,1 milliárd összetett paraméterrel rendelkezik, a ritka szakértői felépítésnek (Mixture-of-Experts) köszönhetően azonban tokenenként mindössze 3,46 milliárd paramétert mozgat meg (tette közzé a fejlesztőcsapat a hivatalos modellkártyáján és a MarkTechPost szakmai beszámolójában). A nyílt súlyú, Apache 2.0 licenc alatt közzétett neurális hálózatot kifejezetten az európai adatvédelmi követelményekhez, szigorúan szabályozott ipari és közigazgatási környezetekhez optimalizálták, akár 1 millió tokenes kontextusablakkal.
Az európai mesterségesintelligencia-fejlesztésben ritkaságnak számít a teljesen független, elejétől a végéig helyben ellenőrzött folyamat: az adatelőkészítést, a modellarchitektúrát, az infrastruktúrát és a kiértékelést is németországi és finnországi adatközpontokban vezényelték le. A projekt közvetlenül igazodik az EU mesterséges intelligenciáról szóló jogszabályához (AI Act) és a GDPR előírásaihoz, az adatelőkészítő folyamat pedig még a tanítás megkezdése előtt automatikusan kitakarította a személyes azonosításra alkalmas adatokat a forrásokból.
Hibrid figyelem és 384 szakértő: a 4,4 százalékos ritkaság titka
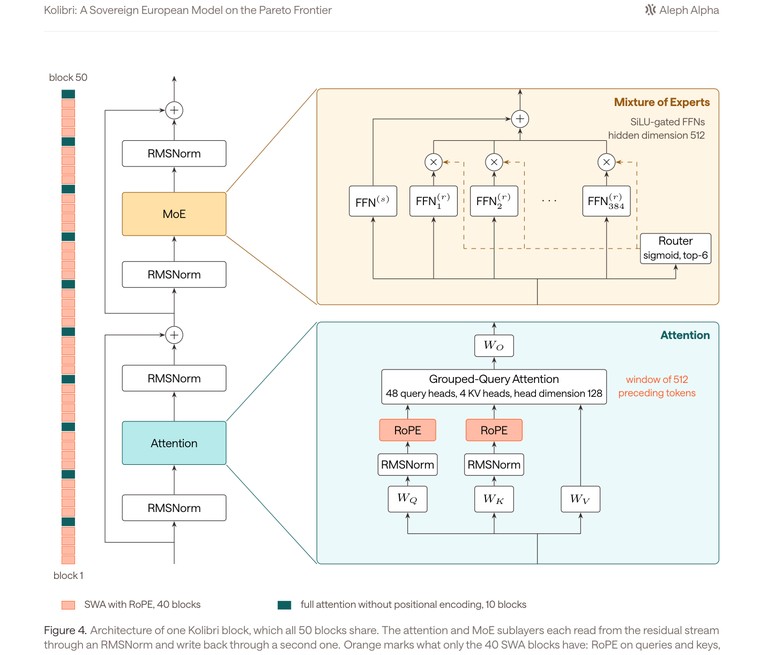
A modell technikai gerincét 50 transzformátor blokk alkotja 2560-as rejtett dimenziószélességgel. Minden egyes rétegben 384 önálló szakértő található: egy szigmoid aktiválású útválasztó minden token esetében a 6 leginkább releváns szakértőt szólítja meg, miközben 1 megosztott szakértő minden számítási lépésben folyamatosan fut. A szakértők közötti egyenletes terheléselosztást a fejlesztők által kidolgozott Exact Quantile Balancing és a terhelési hibainjektálás biztosítja, elkerülve az egyes szakértők túlterhelődését vagy a kihasználatlan neuroncsoportok kialakulását.
A figyelemmechanizmus terén a mérnökök 4:1 arányban ötvözték a csúszóablakos (Sliding-Window Attention) és a csoportosított lekérdezéses (Grouped-Query Attention) eljárásokat. Az 50 blokkból 40 réteg kizárólag az előző 512 tokenre fókuszál fix méretű gyorsítótárral, és mindössze minden ötödik, azaz összesen 10 réteg számítja a teljes kontextus összefüggéseit. Ennek köszönhetően a kulcs-érték (KV) gyorsítótár memóriaigénye nem skálázódik lineárisan a bemeneti szöveg hosszával, lehetővé téve a négyszer hosszabb szekvenciák feldolgozását azonos hardverkeret mellett.
24 billió token és a hallucinációkat gátló Merlin-Arthur protokoll
A tanítási fázis 20 billió token feldolgozásával indult 768 darab NVIDIA B200 gyorsítókártyán (összesen 96 HGX csomóponton), amelyet egy 3,44 billió tokenes köztes tanítás követett 65 ezer tokenes szekvenciahosszon, végül egy 201 milliárd tokenes szakasz zárta 262 ezer tokenes ablakban. A német és angol nyelvű szókincset egy egyedi UniBPE tokenizer kezeli 128 ezer elemmel. Ez német webtartalmakon 4,90 bájt/token sűrűséget ér el, ami 11,2 százalékkal kevesebb tokenfelhasználást jelent az általános modellekhez képest, drasztikusan csökkentve a feldolgozási időt.
Az utótanítás során a felügyelt finomhangolást (SFT) MergeMix eljárással és megerősítéses tanulással (RL) egészítették ki több mint 1,2 millió belső feladaton. A vállalati keresőrendszerek (RAG) szempontjából meghatározó a beépített Merlin-Arthur protokoll: ez megtanítja a modellt arra, hogy határozottan megtagadja a választ vagy jelezze a forráshiányt, amennyiben a csatolt háttérdokumentumok nem tartalmazzák a kért információt. Ez a megközelítés közvetlenül védi a döntéshozókat a mesterséges intelligencia téves konfabulációitól.
Egyetlen gyorsítókártyán elfér a 78 gigabájtos FP8 formátum
A nyílt súlyú modellek legnagyobb akadálya a vállalati szerverigény: a Kolibri azonban kvantált, float8_e4m3fn (FP8) formátumban mindössze 78 gigabájt memóriaterületet követel. Ez azt jelenti, hogy a teljes 78 milliárdos modell kiszolgálható egyetlen 141 gigabájtos NVIDIA H200, B200 vagy B300 gyorsítón, illetve két korábbi H100 SXM5 vagy A100 kártyán a népszerű vLLM kiszolgálókeretrendszeren keresztül.
A teszteredmények alapján a Kolibri az angol nyelvű GPQA Diamond tudományos benchmarkon 84,3 pontot, míg az AIME 2026 matematikai megmérettetésen 96,0 pontot ért el. Ahogy a legújabb beszéd- és ágensmodellek fejlesztésében látjuk, az iparág egyre határozottabban a specializált, hatékony hálózatok felé fordul. Az európai modell sikere bizonyítja, hogy az okosan megtervezett ritka szakértői architektúra képes a zárt forráskódú óriásmodellek logikai szintjét hozni úgy, hogy közben a szuverén adatok soha nem hagyják el a helyi infrastruktúrát.