Nem mindegy, hogyan tölt be egy AI-ágens egy készségcsomagot. Egy friss Cornell–Microsoft Research kutatás (arXiv:2609.09233) szerint hosszú, sok lépéses feladatoknál jobban jár, ha a készséget külön, saját kontextusablakkal rendelkező al-ágensre bízza, nem a saját fejében próbálja végigvinni. A csapat a SkillsBench benchmarkon tesztelte mindkét módszert: ahol a készségcsomag pontosan leírta, mit vár bemenetként és mit ad kimenetként, ott az al-ágenses megoldás látványosan pontosabbnak bizonyult a gyengébb modelleknél. A csere ára: több token megy el a fő ágens és az al-ágensek közötti egyeztetésre.
Miért zavarja össze a túl sok instrukció az ágenst?
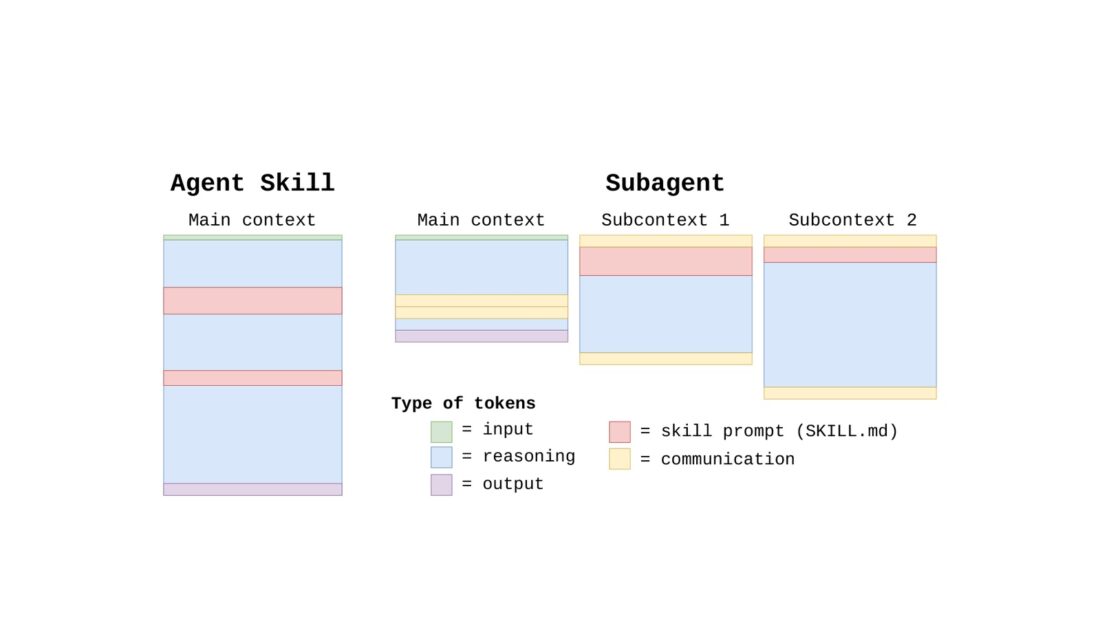
A megszokott gyakorlat egyszerű: ha egy ágensnek bonyolult dolgot kell megcsinálnia, a rendszer bedobja a teljes leírást – például egy vaskos SKILL.md fájlt – közvetlenül a munkamenetbe. Amíg a feladat néhány lépésből áll, ez remekül működik. Hosszabb folyamatoknál viszont ahogy gyűlnek a parancssori kimenetek, a köztes jegyzetek és a hibaüzenetek, a modell figyelme szétesik, és egyre gyakrabban hagy figyelmen kívül korábban megadott szabályokat.
Az al-ágenses felépítésnél a fő ágens nem piszkolja be a saját memóriáját. Amikor egy specifikus feladathoz ér, nyit egy teljesen üres ablakot az al-ágensnek, odaadja neki a pontos instrukciókat és a nyers bemenetet, majd megvárja az eredményt. A próbálkozások, félregépelések és hibaüzenetek az al-ágensnél maradnak és a feladat végeztével törlődnek; a fő koordinátorhoz csak a letisztult végeredmény érkezik vissza.
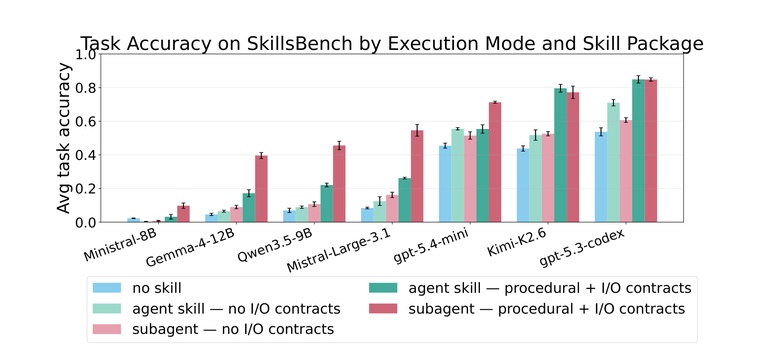
SkillsBench mérések: hol segít az al-ágens és hol felesleges?
A kutatók az OpenHands keretrendszerben futtatták le a teszteket a fenti grafikonon látható hét modellen: Ministral-8B, Gemma-4-12B, Qwen3.5-9B, Mistral-Large-3.1, GPT-5.4-mini, Kimi-K2.6 és GPT-5.3-Codex.
Az eredmények két fontos mintát rajzoltak ki. Egyrészt a kisebb modellek járnak a legjobban a tiszta környezettel: mivel a kontextuskapacitásuk szűkebb, az izolált al-ágens ugrásszerűen javította a feladatmegoldási arányukat. A csúcsmodellek (Kimi-K2.6, GPT-5.3-Codex) egyetlen kontextusban is jobban bírták a terhelést, így náluk a pontossági különbség minimálisra olvadt, bár az al-ágensekkel a felesleges tokenfelhalmozódást náluk is sikerült megelőzni.
Van viszont egy komoly módszertani bökkenő: az al-ágens önmagában nem csodaszer. A kutatás rávilágított, hogy az előny kizárólag akkor mutatkozik meg, ha a készségcsomaghoz szigorú bemeneti-kimeneti (I/O) szerződés tartozik. A SkillsBench eredeti, lazábban megfogalmazott készletén az al-ágenses futtatás semmivel sem volt jobb, sőt néha elmaradt a sima kontextusba töltéstől. A kutatók sikeres futási nyomvonalakból, a Copilot CLI segítségével szintetizálták a szigorúbb csomagokat – ám a 87 feladatból ez csak 64-nél sikerült hibátlanul, ami jól mutatja, mennyi mérnöki előkészítést igényel a dolog éles környezetben.
A koordináció ára
Az izoláció nincs ingyen. Minden egyes al-ágens indítása külön feladatátadási promptot kér, az eredményeket át kell venni és be kell illeszteni a fő szálba. A tanulmány teljes anyaga rámutat, hogy feladatszinten ez folyamatosan növeli az elhasznált tokenek számát.
A gyakorlatban a kérdés tehát az: megéri-e a jelentős extra tokenfogyasztást és a hosszabb várakozási időt az, hogy a kisebb modellek megbízhatóbban dolgozzanak, vagy érdemesebb inkább egy nagyobb kapacitású modellt választani egyetlen szálon?