Míg az elmúlt években a mesterséges intelligencia hardveres vitáit szinte kizárólag a grafikus gyorsítók uralták, az önállóan cselekvő, több lépésből álló ügynökrendszerek (Agentic AI) terjedése új egyensúlyt követel meg az adatközpontokban. A Stanford Egyetemen tartott Hot Chips 38 szimpózium és a vezető félvezetőgyártók bemutatói alapján a komplex döntési folyamatok összehangolása jelentős processzorkapacitást igényel a nyers inferencia mellett.
A szekvenciális döntési fák és a Microsoft–UT Austin kutatás
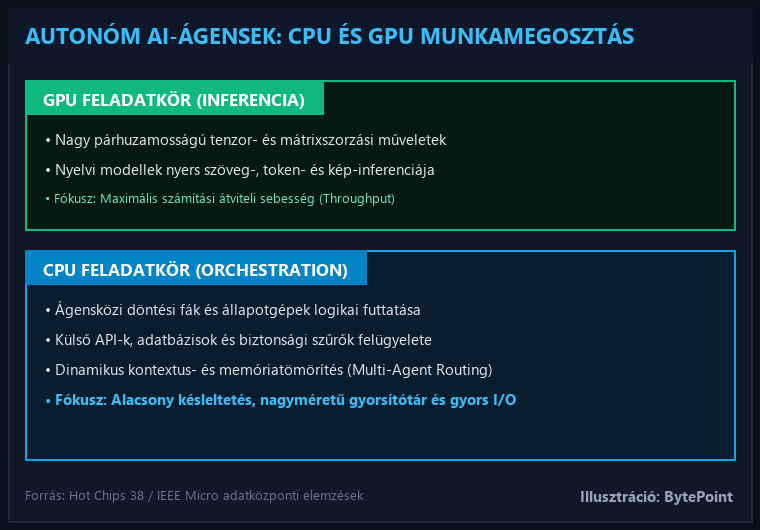
Az eltolódás hátterét a Microsoft Azure mérnökei és a Texasi Egyetem (UT Austin) kutatói részletesen elemezték az Architectural Implications of Agentic AI Workflows (arXiv:2608.04458) című tanulmányukban. A mérések szerint az ügynökfolyamatok működése töredezett: a rendszer folyamatosan váltogat a GPU-n futó neurális inferencia, valamint a CPU-n végzett állapotkezelés, memóriatömörítés, logikai döntési faépítés és külső eszközmeghívások között. Emiatt a kiszolgáló processzor folyamatosan a feldolgozás kritikus útvonalán (critical path) helyezkedik el, a kizárólag GPU-kra méretezett szerverekben pedig kapacitásvesztést okozhat az erőforrások aszinkron várakozása.
A gyakorlati tapasztalatok azt mutatják, hogy a többágenses rendszerek felügyelete jelentősen több processzormunkát igényel, mint az egyszerű csevegőablakok kiszolgálása. Lisa Su, az AMD vezérigazgatója korábban rámutatott, hogy a hagyományos, erősen GPU-túlsúlyos szerverkiépítések helyett az adatközpontok egyre inkább a kiegyensúlyozottabb CPU–GPU arányok felé mozdulnak el, ahogy a döntéshozatali és adatmozgatási lépések száma növekszik.
Hogyan alkalmazkodnak a szerverprocesszorok?
A nagy hardvergyártók a termékkínálatuk fejlesztésével igyekeznek kiszolgálni a megnövekedett koordinációs terhelést:
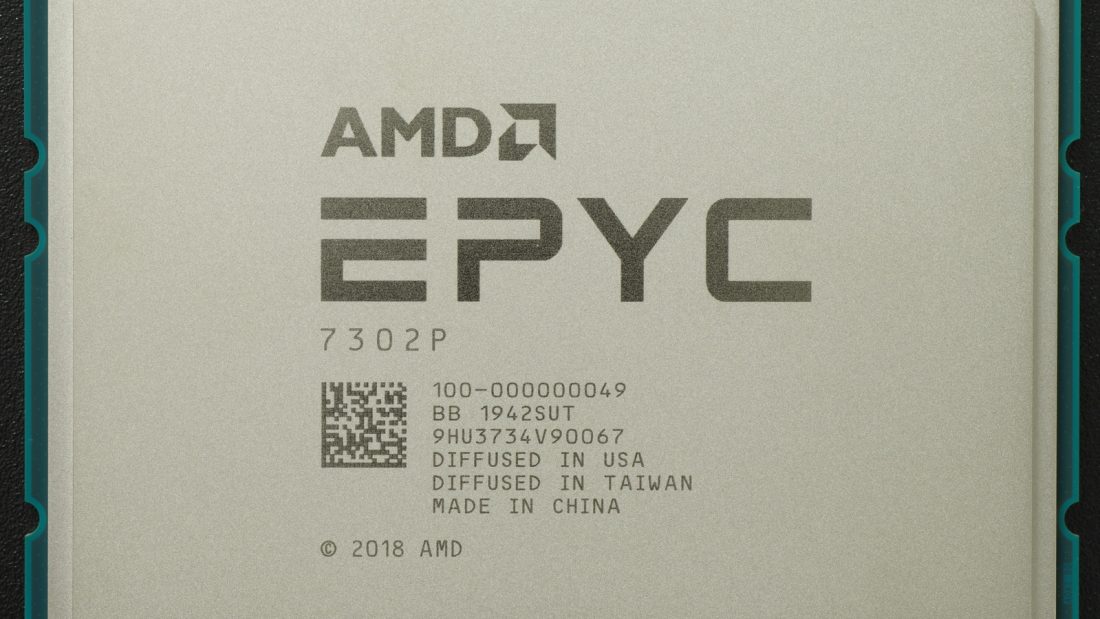
- AMD: Az AMD EPYC sorozat nagymagos („Turin”) konfigurációi bőséges L3 gyorsítótárral és nagy sávszélességű memóriavezérlőkkel segítik az ágensközi kontextusok és állapotgépek alacsony késleltetésű kezelését.
- Intel: A Hot Chipsen bemutatott Diamond Rapids platform és az Intel Xeon architektúra a terheléselosztásra, a biztonsági szűrőkre és a kódvégrehajtási feladatokra fókuszál.
- Arm: Az Arm Neoverse szerverarchitektúra nagy magszámú, energiahatékony chiplet-megoldásokkal és alacsony késleltetésű összeköttetéssel (UCIe) célozza a modern adatközponti infrastruktúrákat.
- NVIDIA: A vállalat a dedikált NVIDIA Vera CPU és a Vera Rubin platform révén a nagy sávszélességű adatmozgatást (ETL) és a gyorsítók folyamatos kiszolgálását helyezi előtérbe.
A folyamat rávilágít arra, hogy a valódi autonóm rendszerek korszakában a nyers gépi számítás mellett a kiszolgáló és döntéshozó processzoros infrastruktúra vált a modern adatközpontok működésének alapvető pillérévé.