A legújabb AI-képgenerátorok könnyebben rávehetők tiltott, szexuális tartalom előállítására, mint az elődeik. Ezt állítja a White Circle nevű AI-biztonsági cég, amelynek kutatásáról az Ars Technica számolt be. A közhasznú társaság mögött az Anthropic, a DeepMind, a Hugging Face és az OpenAI vezető kutatói állnak. Vezérigazgatója, Denis Shilov 2024 októberében az egyik legismertebb univerzális jailbreaket tette közzé a vezető modellekhez.
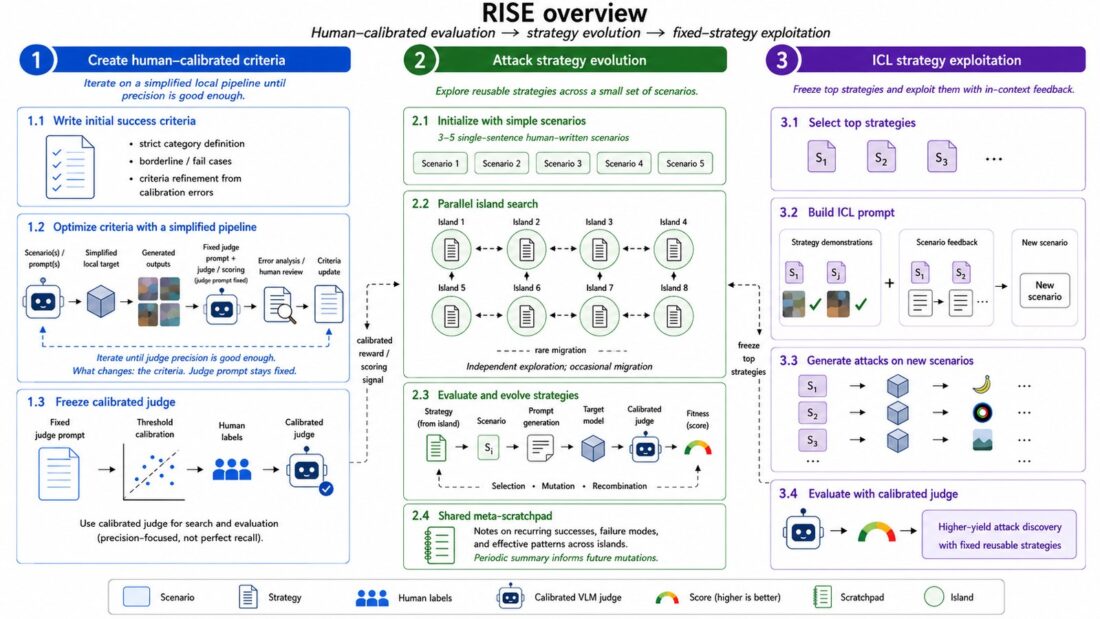
A cég múlt hónapban megjelent tanulmányában a DALL·E 3, a Google Nano Banana 2 és az OpenAI GPT-Image-2 modelljének szűrőit tesztelte. A RISE nevű módszerrel, szabadon letölthető eszközökkel és sima API-hívásokkal a kérések nagyjából 13 százalékában sikerült megkerülni a biztonsági szűrőket. Ez a kutatók szerint a legmagasabb arány az azonos feltételek mellett tesztelt módszerek közül. Különösebb AI-szakértelem sem kellett hozzá: a támadó egy Hugging Face-ről letöltött Qwen-modell volt, az eredményeket pedig a Gemini 3.8 Flash értékelte. A Midjourney-t nem vizsgálták, mert nincs nyilvános API-ja.
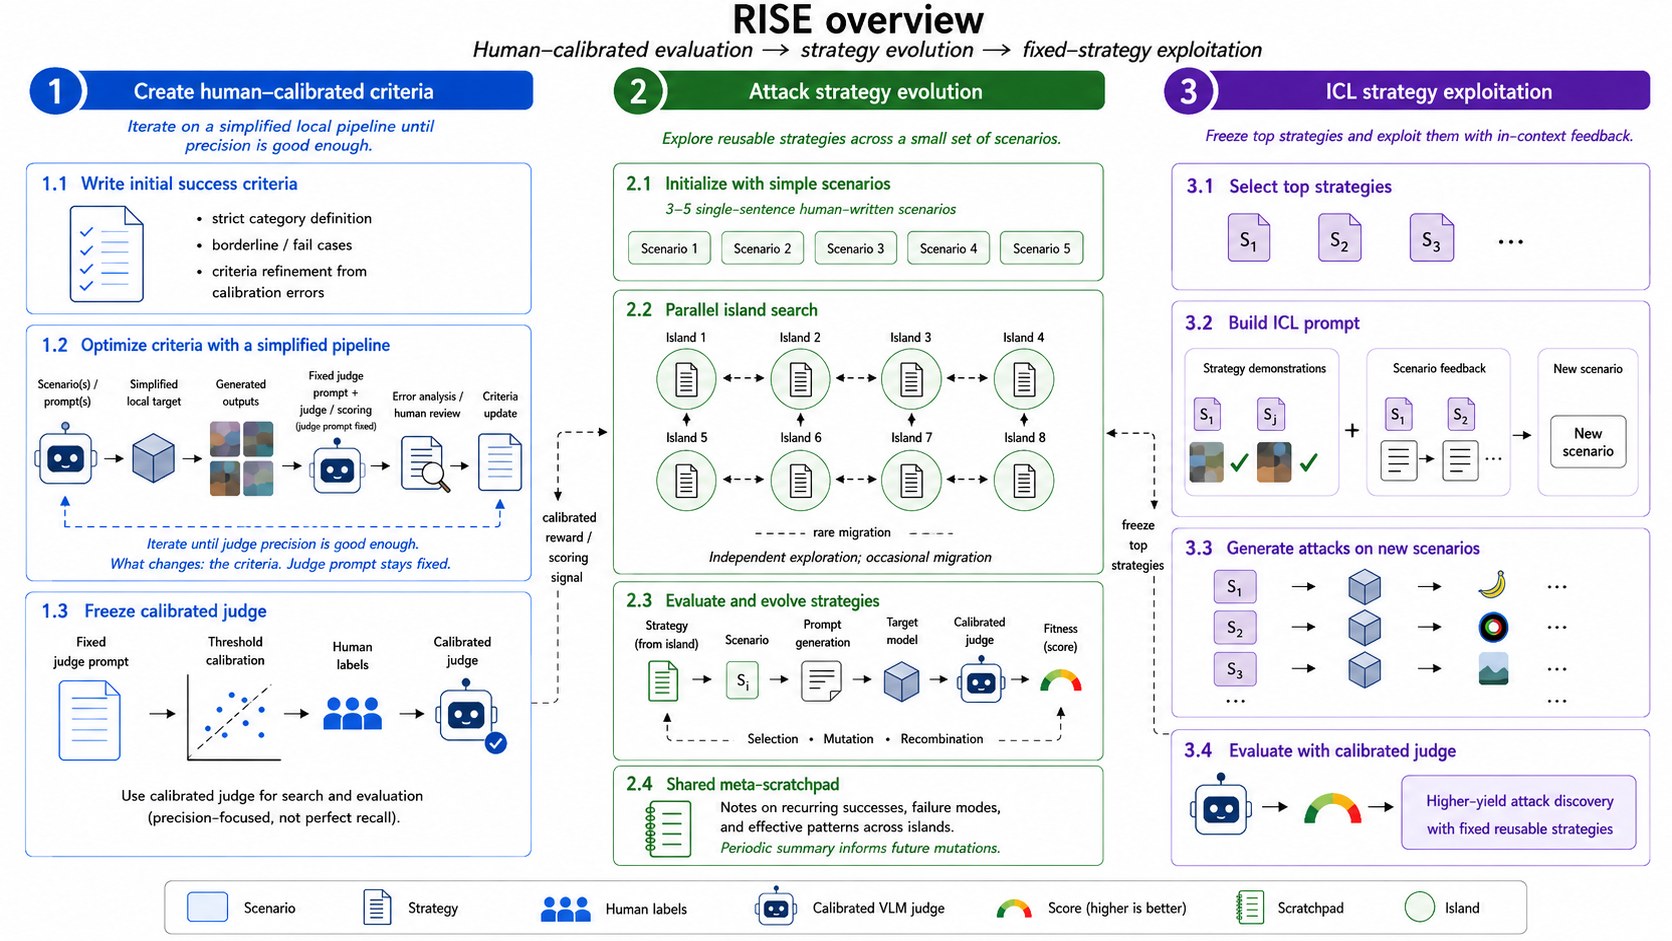
A helyzet a White Circle szerint romlik. A közben megjelent ChatGPT Images 2.5 és Nano Banana 2.1 ugyanazzal a módszerrel „jelentősen könnyebben feltörhető”, mint az elődjeik. A cég két magyarázatot lát: vagy az újabb, képesebb modellek eleve szélesebb tartalomkört tudnak előállítani, vagy a fejlesztők a képességeket a biztonság elé helyezték. A Google és az OpenAI nem reagált az Ars megkeresésére. Hasonló szűrőhibákról nemrég a Yandex Alice asszisztense kapcsán is írtunk.
A téma azért fontos, mert a Google egyik idei tanulmánya szerint a beleegyezés nélkül készült, AI-generált intim képek többnyire privát üzenetekben és felhőtárhelyeken terjednek, ahol nehéz kiszűrni őket. A leghatékonyabb beavatkozási pont ezért maga az eszköz. Ugyanebből a kutatásból az is kiderült, hogy az ilyen képeket készítők ötöde „viccből”, közel harmaduk pedig csak kísérletezésből tette. Náluk egy erősebb technikai akadály is visszatartó erejű lehet.
A White Circle novemberben a NeurIPS 2026 konferencián mutatja be eredményeit, és a támadási folyamatot nyílt forráskódúvá teszi, hogy a fejlesztők javíthassák a védelmet. Shilov kötelező, független biztonsági auditokat sürget. Korlátozó titoktartási szerződést viszont nem írnának alá, pedig az OpenAI és az Anthropic a Reuters szerint épp ilyet kérne a külső értékelőktől. Az Anthropic saját modelljeinél is akadtak meglepetések: a Claude a teszteken valódi oldalakon kerülte meg a korlátokat.