Az Alibaba mesterséges intelligencia fejlesztőcsapata bemutatta a Qwen-Audio-3.1 modellcsaládot, amely öt új architektúrát vonultat fel a beszédfelismerés, a beszédszintézis és a valós idejű hangalapú interakció terén – számolt be a bejelentésről a The Decoder szakmai elemzése. A technológiai fejlesztések mellett a vállalat agresszív árazási stratégiát hirdetett a felhős infrastruktúrájában: a beszédszintézis (TTS) díjait mintegy 70 százalékkal, a valós idejű beszédmodellekét 85 százalékkal, az automatikus beszédfelismerés (ASR) költségeit pedig akár 95 százalékkal mérsékelte a nyugati felhőszolgáltatókkal szemben.
Öt specializált modell a beszédfeldolgozásra
A termékcsalád alapját az automatikus beszédfelismerésre kihegyezett ASR és ASR-Next modellek adják. Az alapmodell a többnyelvű és nyelvjárási beszédfelismerést fejleszti, miközben automatikusan kiszűri a hanganyagokból a töltelékszavakat és az akaratlan ismétléseket. Az ASR-Next változat ezt több beszélőt megkülönböztető diarizációval, másodpercre pontos időbélyegekkel, valamint érzelem- és környezeti zajdetektálással egészíti ki, felismerve a háttérben zúgó gépi zajokat is.
A beszédszintézist a TTS és a kísérleti TTS-Next fedi le. A felhasználók egyszerű szöveges promptokkal szabályozhatják a generált hang hanglejtését, tempóját és stílusát, megadva például a parancsoló vagy a megnyugtató tónust. A TTS-Next architektúra nagy nyelvi modellt ötvöz diffúziós megközelítéssel: a rendszer egyetlen menetben hoz létre emberi beszédet, hangeffekteket és környezeti háttérzenét, komplett filmes hangképet építve fel a bemeneti szöveg alapján.
Valós idejű párbeszéd és hatalmas kontextusablak
A valós idejű kommunikációra tervezett Realtime modell kétirányú, szimultán beszédet és hallgatást tesz lehetővé azonnali megszakítási képességgel. A rendszer figyeli a felhasználó beszédhangulatát: lehangoltságot észlelve automatikusan lassabb beszédtempóra és empatikusabb megfogalmazásokra vált. A kiadott Realtime-Plus változat ráadásul 262 144 tokenes kontextusablakkal dolgozik, ami lehetővé teszi a hosszas, többfordulós ágenses párbeszédek fenntartását és a külső eszközhívások stabil koordinálását.
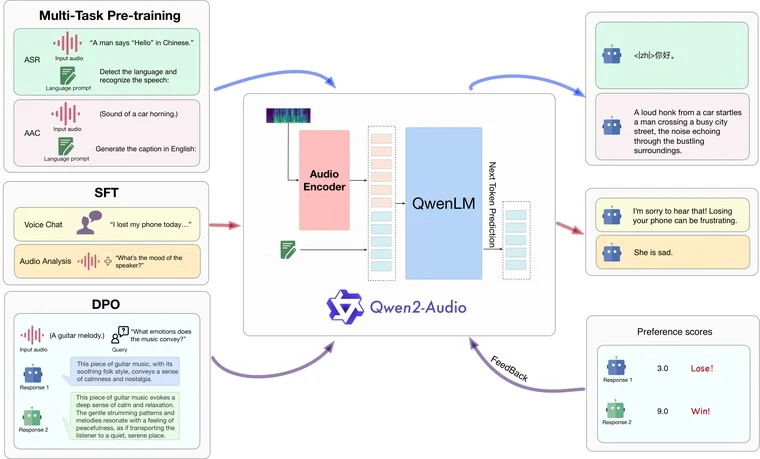
A modellek technikai hátterét részletező nyilvános műszaki dokumentáció szerint a mérnökök az audio kódoló és a nyelvi modell gerincét többcélú illesztőrétegekkel kapcsolták össze. A közvetlen hang-hang következtetés révén a modell átlépi a korábbi, kaszkádolt rendszerek felesleges késleltetési lépcsőit.
A modellcsalád és a felhős árcsökkentés
Az alábbi táblázat a Qwen Audio 3.1 felhozatalát és az Alibaba Cloud Model Studio hivatalos díjcsökkentéseit foglalja össze:
| Modellváltozat | Fő funkció | Kulcsjellemző | Árcsökkentés mértéke |
|---|---|---|---|
| Qwen-Audio-3.1-ASR | Beszédfelismerés | Nyelvjárás-kezelés, töltelékszavak szűrése | Akár 95% |
| Qwen-Audio-3.1-ASR-Next | Beszélőazonosítás | Időbélyegek, érzelem- és zajdetektálás | Akár 95% |
| Qwen-Audio-3.1-TTS | Beszédszintézis | Prompt-alapú stílus- és tónusvezérlés | ~70% |
| Qwen-Audio-3.1-TTS-Next | Teljes hangkép-generálás | Beszéd, hangeffekt és háttérzene egy menetben | ~70% |
| Qwen-Audio-3.1-Realtime | Kétirányú hanginterakció | Full-duplex, 262k kontextus, ágenses vezérlés | ~85% |
A drasztikus árcsökkentés közvetlen kihívást intéz a hangalapú AI-piacot uraló nyugati szolgáltatók felé. A fejlesztők az Alibaba Cloud felületén keresztül azonnal munkára foghatják a modelleket, a nyílt súlyú változatok megjelenése pedig a helyi kiszolgálást tervező vállalati ügyfelek integrációs költségeit is mérsékli.