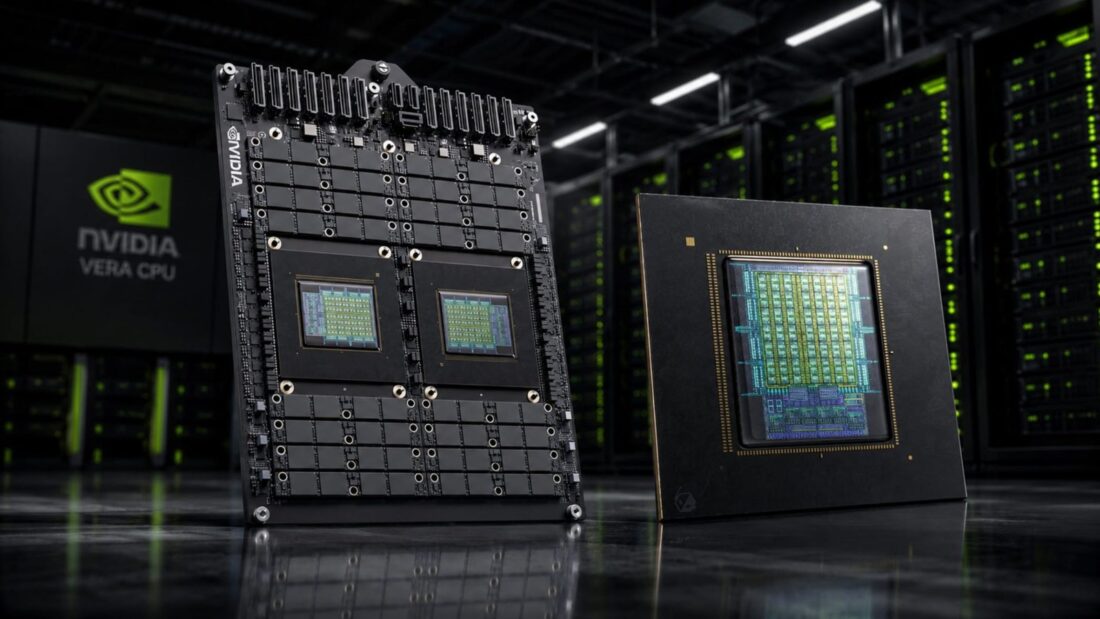
Az elmúlt tíz évben az adatközponti processzoroknál a magszám volt a fő szempont, és ez az egyszálas teljesítmény rovására ment. Az Nvidia Vera CPU csapata szerint most az AI-ügynökök fordítanak ezen. Erről beszéltek a Wccftech-nek adott exkluzív interjúban, ahol a Vera CPU tervezési döntéseit is elmagyarázták.
Magszám vagy magonkénti sebesség?
Az Nvidia mérnökei szerint a 2010-es évek elején az adatközponti processzorok kevesebb, de gyorsabb maggal dolgoztak. Erre példa az Intel Haswell generációja: magas volt az egyszálas teljesítmény, de alacsony az összteljesítmény. A felhőszolgáltatók növekedésével az iparág a sűrűség felé fordult, vagyis minél több mag kellett egy szerverbe. Ehhez az x86-gyártók chipletekre, azaz több kisebb lapkából összerakott processzorokra váltottak. „Ami ebben az időszakban sérült a CPU-tervezésben, az az egyszálas teljesítmény és az órajelenként végrehajtott utasítások száma (IPC), mert chipleteknél egyszerűen nincs hely a lapkán a magonkénti teljesítményre tervezni” – mondta a csapat.
Az AI-ügynökök viszont folyamatosan ingáznak a GPU és a CPU között. A GPU végzi a „gondolkodást”, a CPU a soros feladatokat, például Python-szkripteket, fordítást és eszközhívásokat. A GPU a drágább erőforrás, ezért nem várhat a CPU-ra. „Azt akarjuk, hogy az ügynök a CPU-n gyorsan végezzen a soros munkával, aztán visszamenjen a GPU-ra a következő gondolkodási lépéshez, mert a GPU-k még mindig az AI-gyár legértékesebb eszközei közé tartoznak” – magyarázták. Ez olyan, mint egy étterem, ahol a drága séf (a GPU) nem állhat tétlenül csak azért, mert a pincér (a CPU) lassan hozza a rendelést.
Mitől más a Vera?
- Monolitikus lapka: minden mag egyetlen szilíciumdarabon van, így a chip egyik sarkában lévő mag lapkahatár átlépése és késleltetés nélkül éri el a másik sarokban lévőt. A belső sávszélesség (bisection bandwidth) 3,4 TB/s, az Nvidia szerint háromszorosa a vezető x86-os chipnek.
- Saját LPDDR5X memória-alrendszer a nagy memória-sávszélességért, és a második generációs Nvidia Scalable Coherent Fabric összeköttetés.
- Spatial Multithreading: az Nvidia saját többszálas megoldása, amely fixen kiosztja a „dolgozó” és az I/O szálakat, így terhelés alatt sem veszi el egyik a másik elől a ciklusokat. A csapat szerint a Phoronix tesztje ezzel nagyjából 20 százalékos gyorsulást mért.
Az Nvidia állítása szerint a Vera 1,5-szer gyorsabb, mint az elődje, a Grace, és ügynöki feladatokon (Python-szkriptek, LLVM-fordítás) akár kétszer gyorsabb a vezető x86-os processzornál, mértani átlagban 1,6-szor. Az Nvidia azért tervezhetett monolitikus lapkát, mert csak az adatközpontra kellett figyelnie, míg az AMD-nek és az Intelnek egy architektúrával kell kiszolgálnia a kliensgépeket és a szervereket is. A chipletekkel szemben ugyanakkor nincsenek elvi fenntartásaik: „Nincs vallásunk ebben, inkább az a kérdés, mi a helyes ahhoz, amit el akarunk érni.”
Önálló CPU-rackek az ügynököknek
Az Nvidia a Grace-szel még a „legjobb gazdagépet” akarta megépíteni, vagyis a GPU-kat kiszolgáló processzort. Azóta rájött, hogy az ügynökök eszközhívásaihoz és a megerősítéses tanításhoz tisztán CPU-ból álló rackekre is szükség van. A Verát ezért önálló processzorként is árulja. A CPU és GPU arányáról a csapat nem mondott számot. Szerintük ez az arány a CPU-k felé tolódik, és van olyan szolgáltató, amely egyetlen ügyfélnek 400 000 homokozót (sandboxot) futtat. Az RTX Spark laptopchipben egyébként a Grace fogyasztói változata dolgozik. A friss ComputerBase-teszt szerint ennek magjai már nem a legújabbak. Hogy mennyi CPU kell az ügynökökhöz, azt a Meta Muse VM-igénye is jól mutatja.
A Vera Rubin sávszélesség-adatait az Nvidia időközben csendben csökkentette a hivatalos oldalán.