A diffúziós modellek másodpercek alatt állítanak elő fotórealisztikus videórészleteket, a percekig tartó, összefüggő történetek létrehozása viszont eddig súlyos vizuális inkonzisztenciába torkollt. A Google Research kutatói, Yale Song és Yiwen Song részletes műszaki publikációban mutatták be az AI Video Co-Director nevű rendszert. Az egységes, többágenses keretrendszer globális optimalizációként kezeli a több snittből álló narratívák vizuális folytonosságát, közvetlenül a Gemini és Veo alapmodellekre épülő orkesztrációs rétegként működve.
Szemantikai sodródás és a hibahalmozódás korlátai
A piacon lévő videógeneráló eljárások a jeleneteket egymás után fűzött modulokkal állítják elő. Ez a lineáris láncolás a gyakorlatban szemantikai sodródáshoz (semantic drift) vezet: a szereplők ruházata, arckaraktere vagy a díszlet fokozatosan átalakul a kameraváltások során. Ezt súlyosbítja a hibahalmozódás (cascading failures), amikor egy korai képkockán megjelenő képhiba a későbbi jelenetek szintézisét is torzítja. A hagyományos rendszereknél emellett gyakori a tartalomösszeomlás (content collapse), amikor a cselekmény képtelen érdemben továbblépni.
A kutatók rámutattak, hogy a jelenség a klasszikus kredit-hozzárendelési problémára vezethető vissza: szinte lehetetlen visszakövetni, hogy a végleges videóban jelentkező vizuális anomáliát melyik korábbi prompt fogalmazása idézte elő. A most bemutatott architektúra a kreatív alkotást szétválasztja a folytonosság felügyeletétől, a minőség biztosítását pedig tesztidőbeli (test-time) célfüggvényként határozza meg, hasonlóan az összetett videógenerálási referencia-kihívásokhoz.
Négyágenses keretrendszer a globális felügyeletért
A percekig tartó koherens videók előállítását négy egymáshoz kapcsolódó technológiai pillér végzi. Az első az AI Video Co-Director, amely a COLM 2026 konferencián debütál. A rendszer egy Multi-Armed Bandit (MAB) algoritmusra támaszkodva keresi az optimális egyensúlyt az új narratív utak feltárása és a bevált vizuális konfigurációk alkalmazása között. Három dimenziót hangol: a kreatív szándékot, a történetstruktúrát és az operatőri esztétikát. A hierarchiát az Orchestrator Agent vezérli, a Pre-Production Agent felépíti a storyboardot, a Production Agent pedig specializált al-ágensekkel (Keyframe Agent a vizuális horgonyokért, Video Agent a mozgásért, Audio Agent a hangsávért) hajtja végre a feladatot, miközben egy multimodális bíráló ágens (MLLM Judge) jutalmazási jelekkel finomítja a generálási hurkokat.
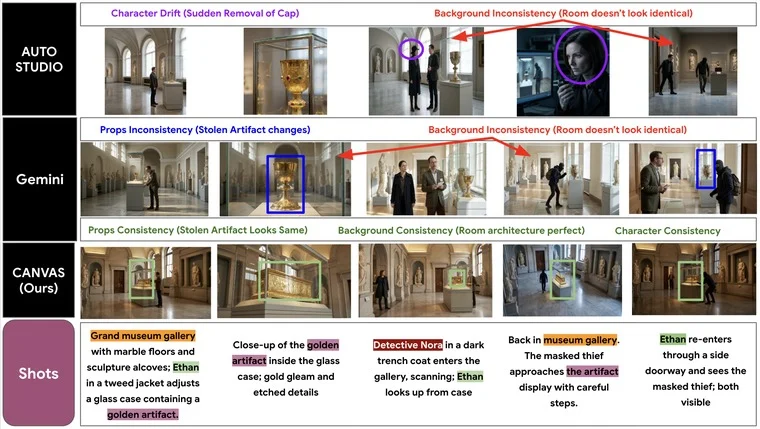
A második pillér a CANVAS (EMNLP 2026 konferencia), amely perzisztens vizuális memóriával valósít meg világállapot-követést. Rögzíti a karakterek azonosságát, a tárgyak állapotát és a helyszínek térbeli geometriáját. A múzeumi rablásos tesztelés során míg az alapmodellként használt Gemini modellek és a rivális AutoStudio esetében a tolvaj sapkája eltűnt és a kiállítási terem elrendezése torzult, a CANVAS segítségével a szereplők és tárgyak teljesen változatlanok maradtak a visszatérő snitteknél.
A harmadik komponens az A²RD, egy autoregresszív videógeneráló architektúra. A szegmensenkénti előállítás során dinamikusan vált az extrapoláció (a cselekmény előregördítése) és az interpoláció (a visszatérő szereplők rögzítése az eredeti tervekhez) között. A kutatók ezzel egy tízperces folyamatos kisfilmet generáltak a szereplők mutációja vagy a díszletek szétesése nélkül. A negyedik elem a VQQA, amely feketedobozos prompt-optimalizálóként működik: ahelyett, hogy a pixeleket közvetlenül módosítaná, kérdés-felelet alapú vizuális kritikákból szemantikai gradienseket képez, és szöveges szinten igazítja ki a promptot a kompozíciós és fizikai hibák elhárítására.
Szabványosított terheléstesztek és benchmarkok
A keretrendszerek hatékonyságát három új mérési eljárással igazolták. A GenAD-Bench 50 fiktív márka 400 forgatókönyvén vizsgálta a szigorú marketing-megkötések betartását szerzői jogi konfliktusok nélkül, ahol a Co-Director elérte a 81,4-es csúcspontszámot. A HardContinuityBench bonyolult storyboardok segítségével azt tesztelte, mi történik, ha egy szereplő vagy tárgy hosszú jelenetek után tér vissza a kamera elé. Az LVBench-C adatbázis 120 forgatókönyve pedig megkövetelte, hogy a kritikus vizuális elemek legalább 10 szegmensen keresztül távol maradjanak a képernyőtől, mielőtt narratív indoklással újra feltűnnek.
A többágenses architektúra az orkesztrációs és ellenőrzési feladatok szétválasztásával, valamint a tesztidőbeli minőségoptimalizálással akadályozza meg a vizuális drift kialakulását a percekig tartó generatív videókban.