Részletes folyamatábrán mutatta be az AMD Research a fejlesztés alatt álló neurális renderelési (Neural Rendering) architektúráját. A Kepler_L2 által közzétett mérnöki vázlat és a Digital Foundry szakmai elemzése megerősíti: a rendszer a kutatócsoport 2025 júliusában megkezdett látens diffúziós munkájának közvetlen továbbfejlesztése, amely a rivális megoldásoktól eltérő elven, generatív neurális hálóval állítja elő a valós idejű közvetett megvilágítást.
Latent Diffusion UNet és geometriai adapterek
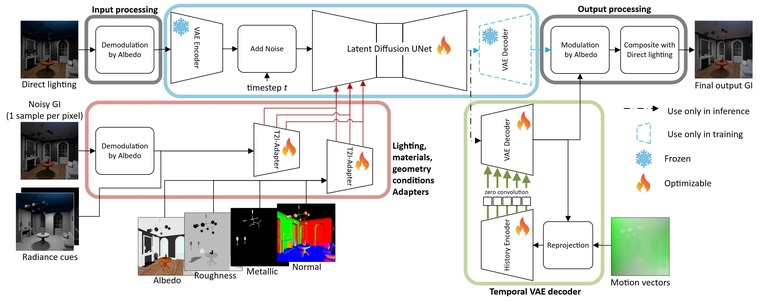
A mérnöki architektúra a közvetlen megvilágításból (Direct lighting) és a mindössze képpontonkénti egyetlen mintából számolt, zajos közvetett megvilágításból (Noisy GI, 1 sample per pixel) indul ki. A folyamat első lépéseként a rendszer leválasztja az albedó összetevőt (Demodulation by Albedo), majd egy rögzített, fagyasztott súlyozású VAE enkóderen keresztül látens térbe juttatja a jelet. A zaj hozzáadása után a képalkotás magját egy optimalizálható Latent Diffusion UNet hálózat végzi el.
A diffúziós hálózat finomhangolt feltételes adaptereken (T2I-Adapter) keresztül kapja meg a renderelési geometriát. A bemeneti oldalon külön rétegként érkezik az albedó, az érdesség (roughness), a fémes jelleg (metallic), a felületi normálisok (normal map) és a kisugárzási támpontok (radiance cues). Ezek a pufferek biztosítják, hogy a neurális úton generált fények pontosan kövessék a 3D-s tér felületeit és fizikai anyagtulajdonságait.
Temporális VAE dekóder és a DLSS 5 különbségei
A közösségi médiában megfogalmazott feltételezésekkel szemben a technológia felépítése eltér a hagyományos felskálázóktól. Míg a DLSS 5 és a klasszikus sugárkövetési zajszűrők az időbeli újrahasznosításra és a meglévő fényminták szűrésére fókuszálnak, az AMD megoldása egy generatív látens modellt állít a csővezeték központjába, amely alacsony mintaszámú megvilágítási adatokból és a renderelési geometriából önállóan szintetizálja a teljes közvetett fényeloszlást.
A valós idejű futtatás stabilitását egy különálló temporális VAE dekóder szavatolja. Ez a modul mozgásvektorok (motion vectors) és korábbi képpufferek alapján végzett újraprojektálással (reprojection), valamint egy előzmény-enkóderrel (History Encoder) és zéró-konvolúciós rétegekkel akadályozza meg a diffúziós hálókra jellemző villódzást (flickering). A kimeneti szakaszban az albedó visszamodulálása és a közvetlen fénnyel való kompozitálás után áll elő a végleges, fotorealisztikus globális megvilágítás.
A fenti szakmai szöveg konyhanyelven annyit tesz, hogy ahelyett, hogy a videókártya nyers erőből, fénysugaranként számolná ki egy szoba bevilágítását és utólag simítaná el a zajt (mint a hagyományos megoldások), az AMD egy AI-festőt ültetett a folyamat közepébe. Ez a mesterséges intelligencia a térbeli vázlatok alapján pillanatok alatt „kitalálja” és megfesti a fotorealisztikus fényeket, miközben a stabilizátor modul megakadályozza az AI-generálásra jellemző villódzást mozgás közben.
A neurális renderelési csővezeték fázisai
A közzétett architektúra alapján a feldolgozás négy egymásra épülő fázisban zajlik le:
| Feldolgozási szakasz | Alkalmazott komponensek | Funkció a renderelésben |
|---|---|---|
| Bemeneti előkészítés | Demodulation by Albedo, VAE Encoder (fagyasztott) | A közvetlen fény látens térbe transzformálása (a zajos közvetett fényminták pedig a T2I-Adapterek feltételes bemenetére kerülnek) |
| Feltételes vezérlés | T2I-Adapterek, anyagminták, normálisok | A felületi érdesség, fémes hatás és geometria illesztése a diffúziós folyamathoz |
| Látens diffúzió | Latent Diffusion UNet | A közvetett fénysugarak generatív előállítása alacsony mintaszám mellett |
| Kimeneti rekonstrukció | Temporal VAE Decoder, Reprojection, History Encoder | Időbeli stabilitás biztosítása mozgásvektorokkal és végső képi kompozitálás |
A technológia gyakorlati integrációja a jövőbeli RDNA grafikus architektúrák hardveres AI-gyorsítóira támaszkodhat, elkerülve a hagyományos sugárkövetés magas hardverköltségét.