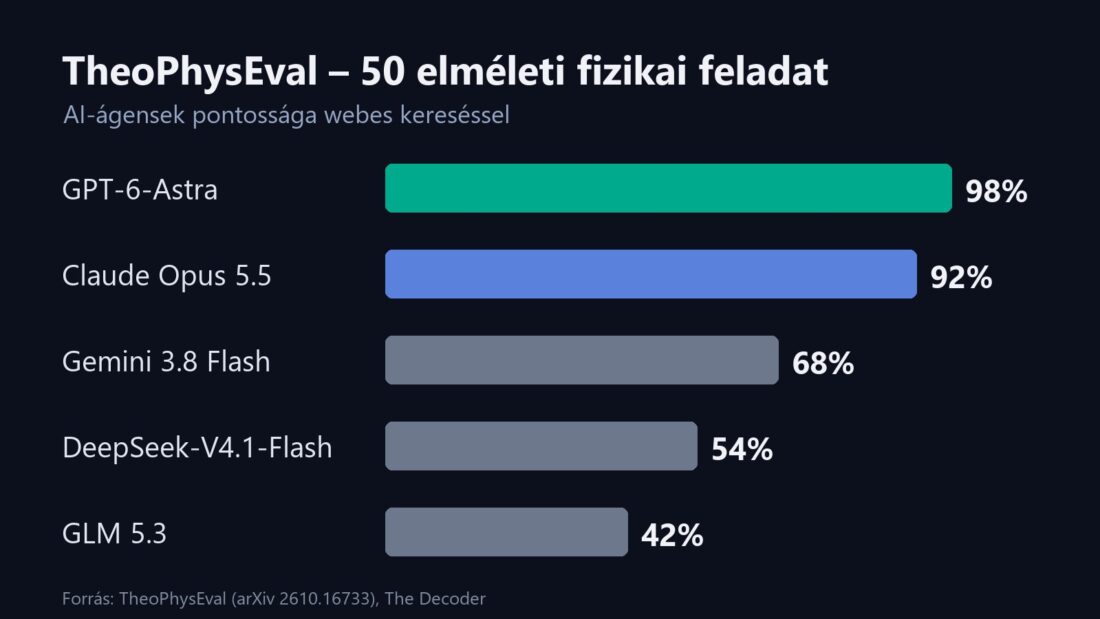
Az OpenAI GPT-6-Astra modellje 50 kiadatlan, kutatási szintű elméleti fizikai feladatból 49-et helyesen oldott meg, emberi segítség nélkül, feladatonként átlagosan kevesebb mint 3 dollárért. Az eredmény a TheoPhysEval nevű új tesztből származik, amelyet 35 kutató állított össze. A The Decoder szerint a szerzők között az indiai ICTS, a Harvard, a KU Leuven és a Google DeepMind kutatói is szerepelnek.
A feladatokat szándékosan nem a fizika nagy nyitott kérdéseiből válogatták. Olyan „rutin” kutatómunkát modelleznek, amikor ismert módszereket kell egy kicsit módosított kérdésre alkalmazni. Ilyen feladatot gyakran kapnak az első kutatási projektjükként a doktoranduszok. A szerzők sokszor a saját friss cikkeik számításaiban írtak át néhány értéket, hogy az új eredményt ne lehessen kitalálni a régiből. Egy átlagos feladatot az adott terület egyik vezető szakértője AI nélkül nagyjából egy nap alatt oldana meg, a szomszédos területek szakértőinek jóval tovább tartana. A tesztelt ágensek valós körülmények között dolgoztak: kereshettek a szakirodalomban, és saját programokat írhattak a numerikus és szimbolikus számításokhoz.
A The Decoder összesítése szerint az eredmények így alakultak:
- GPT-6-Astra (OpenAI Codex környezetben): 98%, 49 helyes megoldás az 50-ből, a teljes teszt nagyjából 116 dollárba került
- Claude Opus 5.5 (Claude Code-ban): 92%
- Gemini 3.8 Flash: 68%
- DeepSeek-V4.1-Flash: 54%
- GLM 5.3: 42%
Meglepő, hogy az internet-hozzáférés alig számított. Webes keresés nélkül az Astra és az Opus is 92 százalékot ért el, pedig sok feladat olyan kutatási cikkek képletein alapul, amelyeket a modellek nem kaptak meg. A szerzők szerint ez arra utal, hogy a vezető nyelvi modellek az elméleti fizika szakirodalmának nagy részét gyakorlatilag „megjegyezték”. A gyengébb modellek viszont olyan hibákat is vétettek, amelyeket egy szakértő azonnal kiszúrna. Egy fekete lyukas feladatnál például a Gemini és a GLM változtatás nélkül átmásolta egy korábbi cikk ötdimenziós képleteit, pedig négydimenziós téridőre kellett volna átírni őket. Az Astra „hibáinak” egy része ráadásul a mintamegoldásokban rejlő apró tévedésnek bizonyult: ezek javítása után az Astra válasza minden esetben helyes volt.
Ha a modellek ilyen jól számolnak, miért nincs még AI-vezette áttörés a fizikában? A szerzők szerint a konkrét, ellenőrizhető számítás a kutatás legvégén jön. Előtte valakinek fel kell építenie egy elméletet, és fel kell tennie neki a „jó” kérdéseket. Ha egy probléma túl nehéznek bizonyul, egy jó kutató átvált egy egyszerűbb, de ugyanolyan érdekes rokon kérdésre. Ebben a mai ágensek gyengék, és hiányzik belőlük az az „ízlés” is, amellyel a fizikusok megérzik, mi érdekes. Amikor új feladatokat kellett kitalálniuk, olyan részletekben vesztek el, amelyeket egy ember unalmasnak találna. A matematikában ugyanakkor már nagyobb a hatás: az OpenAI szerint egyik modellje megoldotta a folyadékáramlást leíró Navier–Stokes-egyenletekkel kapcsolatos problémát. Ezt az eredményt plágiumvita is övezte.
A kutatók szerint ennek már most vannak következményei. A teszt egyes feladatai nemrég még jó első kutatási projektek lettek volna a pályakezdőknek, ma viszont már nem azok. Az elméleti fizika eddig sokkal kevesebb pénzt igényelt, mint a kísérleti, ezért a lehetőségek viszonylag egyenlően oszlottak el. Ha a nehezebb problémákhoz drága AI-futtatások kellenek, egy kutatócsoport költségvetése többet számíthat abban, mire képes. A feladatokat és a tesztkörnyezetet bárki letöltheti a Hugging Face-ről. Az OpenAI következő modelljeiről itt írtunk.