Az Alibaba Cloud által gondozott Qwen modellcsalád alig három és fél év alatt a nyílt és zárt mesterségesintelligencia-piac egyik leggyorsabban skálázódó ökoszisztémájává vált – derül ki a MarkTechPost részletes technikai elemzéséből. A kezdeti, 2023 tavaszán zárt bétaként indult Tongyi Qianwen csevegőtől a fejlesztők a 2026 augusztusában bemutatott, 2,4 billió (2,4T) paraméteres Qwen3.8-Max zászlóshajóig jutottak el. A növekedés a nyers paraméterszám duzzasztása helyett az architektúra átfogó átalakítására és a számítási hatékonyságra épült: a sűrű (dense) hálóktól a ritka szakértői keverék (MoE) rendszerekig tartó fejlődés ma az élvonalbeli zárt amerikai modellek közvetlen kihívója.
A Tongyi Qianwentől az első nyílt súlyokig
A fejlesztési folyamat 2023 áprilisában indult el, amikor a vállalat bemutatta a Tongyi Qianwen nevű, kizárólag meghívásos alapon tesztelhető csevegőt. A név kettős jelentést hordoz: a „Tongyi” az egységes intelligenciára, míg a „Qianwen” az ezer kérdés megválaszolására utal.
A stratégiai fordulat 2023 augusztusában érkezett el, amikor a mérnökcsapat szakított a tisztán felhős monolit megközelítéssel, és közzétette a Qwen-7B, valamint a csevegésre finomhangolt Qwen-7B-Chat modellt. Ezt követte a kisebb eszközökre szánt 1,8 milliárdos és a nagy nyelvi modellt jelentő 72 milliárdos változat. A modellcsalád az Apache 2.0 licenc révén azonnal megjelent a nyílt forráskódú közösség helyi futtatókörnyezeteiben (Ollama, vLLM), teret engedve a független kutatási projekteknek és finomhangolásoknak.
A Qwen2 és 2.5 korszak: MoE és 18 billió token
2024-ben a Qwen architektúra jelentős generációváltáson esett át. A Qwen2 széria bevezette a ritka szakértői architektúrát (Sparse Mixture-of-Experts), ahol a teljes paraméterkészletből (például az 57 milliárdos Qwen2-57B-A14B modellnél) tokenenként mindössze 14 milliárd paraméter aktiválódott. Ez drasztikusan csökkentette a következtetési (inference) késleltetést a kiszolgálói oldalon.
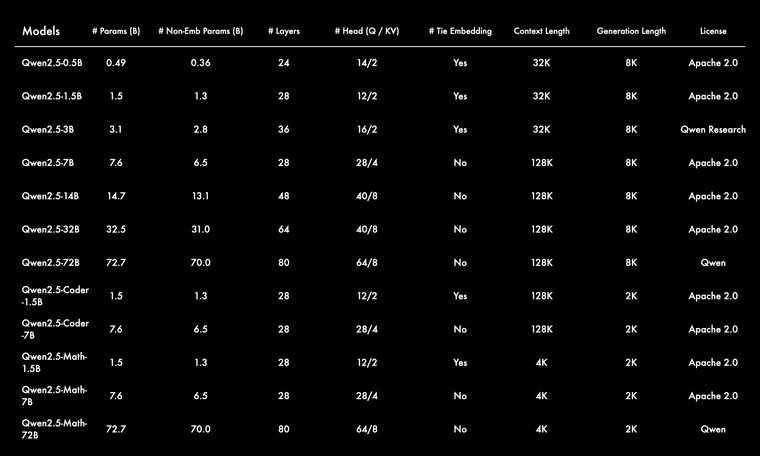
A 2024 végén megjelent Qwen 2.5 sorozat tovább növelte a tanítási adatbázis méretét: az alapmodelleket 18 billió (18T) tokenen tanították elő, a kontextusablakot pedig 128 ezer tokenre bővítették. Ezzel párhuzamosan célzott specializációk jelentek meg: a Qwen2.5-Coder a forráskód-generálásban, míg a Qwen2.5-Math a formális matematikai levezetésekben mutatott fel kiemelkedő pontszámokat a Hugging Face modellkártyáin és a nyílt ranglétrákon.
Hibrid figyelem és autonóm szoftvermérnöki feladatok
A 2025 áprilisában bevezetett Qwen3 generáció már 36 billió tokenes előtanítási korpuszra támaszkodott, és megjelent benne a hibrid érvelési mechanizmus, amellyel a modell dinamikusan képes szabályozni a válaszadás előtti gondolkodási lánc hosszát. Hasonló ritkítási és rétegzési elveket alkalmaz az európai térfélen az Aleph Alpha Kolibri nyílt MoE modellje is a csúszóablakos figyelem bevezetésével.
A fejlesztési ív a 2026 augusztusában kiadott Qwen3.8-Max zászlóshajóban csúcsosodott ki. Az Alibaba Group hivatalos közleménye szerint a modell összesen 2,4 billió paramétert számlál, ritka MoE felépítése révén viszont tokenenként mindössze 95 milliárd paraméter aktiválódik a számítások során. A bemeneti ablak eléri az 1 millió tokent.
A rendszer tervezésénél kiemelt szempont volt az autonóm AI-ágensek támogatása és a hosszú időtávú feladatok (long-horizon tasks) ellátása. A belső teszteken a Qwen3.8-Max 16 napon keresztül futtatott egy valós szoftverfejlesztési projektet emberi beavatkozás nélkül. A folyamatban egy zárt mérnöki ciklust tartott fenn a kódgenerálás, az egységtesztek futtatása, az előnézet és a hibanaplók elemzése között, aminek eredményeként elkészítette az oh-my-cli nevű, önfejlődő keretrendszert a nyílt forráskódú tárolójában.
Multimodális kiterjesztés és következtetési költségek
A Qwen3.8-Max natív vizuális intelligenciával működik. Képes több száz oldalas műszaki dokumentációk, komplett videófolyamok és 100 órás élő közvetítések beolvasására, ezekből azonnal interaktív, kereshető tudásbázist építve. Az új RecreationBench tesztkörnyezetben a modell fekete doboz módban – internetkapcsolat és a mögöttes forráskód ismerete nélkül – kizárólag a vizuális visszacsatolások és a felhasználói felülettel folytatott interakciók alapján rekonstruált működő alkalmazásokat.
A nagy nyelvi modellek terjedésében a kulcskérdés a kiszolgálási költség: egy sűrű 2,4 billió paraméteres modell kiszolgálása kezelhetetlen infrastruktúrát követelne, a 95 milliárdos aktív ablak viszont a vLLM és a DashScope felhős infrastruktúráján kiszámítható tokenárakat biztosít. Az Alibaba a legnagyobb Max változatot API-n keresztül és a QwenWork munkahelyi platformon kínálja, miközben a kisebb desztillált változatok nyílt súlyait továbbra is közzéteszi.
A számítási kapacitás és a ritka aktiváció finomhangolása határozza meg a komplex szoftvermérnöki ágensrendszerek gyakorlati futtathatóságát.