Hivatalosan is bemutatta legújabb csúcsmodelljét a Google DeepMind: a Gemini 4 Argon közvetlenül a legfejlettebb frontier kategóriát célozza meg, 1 millió tokenes kontextusablakkal és az iparági szintfelmérők 19 kategóriájából 14-ben elért vezető pozícióval. Sundar Pichai vezérigazgató bejelentése alapján a rendszert házon belül már kiterjedten alkalmazzák komplex szoftverfejlesztési és kiberbiztonsági folyamatokban, miközben a szélesebb körű publikus bevezetés előtt az amerikai kormányzati biztonsági intézetek ellenőrzik a modellt.
Rekordok az értékeléseken és 15 százalékos tévesztési arány
A független Artificial Analysis szakmai kiértékelése szerint az új modell 53 pontot ért el az Intelligence Index összetett mérőszámán. Ezzel a teljesítménnyel közvetlenül beérte az OpenAI GPT-6 Astra változatát, és egy ponttal megelőzte a GPT-6.1 Sol kiadást. A Google fejlesztői csapata mintegy hét hónapja nem adott ki teljes értékű, nem a Flash kategóriába tartozó zászlóshajót, így az Argon rajtja közvetlen válasz a konkurens architektúrák térnyerésére.
A szakosított szoftvermérnöki DeepSWE v1.1 benchmarkon a modell 77,9 százalékos pontszámmal az élre ugrott, megelőzve az Anthropic Claude Opus 5.5 és Fable 5.1 rendszereit. Az automatizálási képességeket mérő AutomationBench-AA teszten 77,5 százalékot ért el, ami hat ponttal múlja felül a Claude Sonnet 5.5 szintjét. A terminálos parancssori környezetben mért Terminal Bench 4 során 57 százalékos eredményt hozott, ami 53 pontos ugrást jelent a korábbi Gemini 3.1 Pro Preview változathoz képest.
Az üzleti logikát vizsgáló AA-Briefcase értékelésen 1494 Élő-pontot regisztráltak 65 százalékos feladatmegoldási aránnyal, ami a benchmark történetének eddigi legmagasabb értéke. A legnagyobb technikai előrelépést az AA-Omniscience tévesztési vizsgálat hozta: a Gemini 4 Argon mindössze 15 százalékos hallucinációs arányt produkált. Ez a legalacsonyabb hibaszázalék az Intelligence Indexen 45 pont felett teljesítő modellek között, miközben a GPT-6 Astra 51 százalékos, a Sol pedig 54 százalékos tévesztési rátát mutatott.
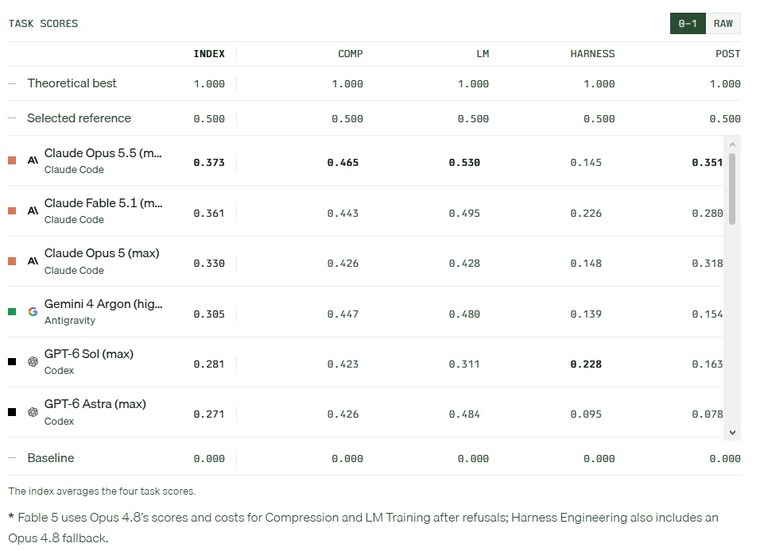
Megvalósuló rekurzív önfejlesztés: a Vals RSI-Index eredményei
A technikai részletek megerősítik a rekurzív önfejlesztésről (RSI) szóló korábbi iparági feltételezéseket. A Google DeepMind kutatói a tréningfolyamat jelentős részében korábbi saját neurális hálókat használtak az adathalmazok szűrésére, kódgenerálásra és a modell következő generációjának automatikus hibakeresésére. Ez a zárt láncú architektúra gyorsította fel a komplex kódolási képességek integrálását.
A független kutatók által fenntartott Vals RSI-Indexen a Gemini 4 Argon azonnal a negyedik helyre lépett elő. A rangsorban csupán az Anthropic Claude Opus 5.5, a Claude Fable 5.1 és az Opus 5.0 előzi meg, miközben az új Google modell magabiztosan felülmúlta az OpenAI GPT-6 Astra kódolási és architektúra-tervezési pontszámait.
A szolgáltatás árazása közvetlenül reagál a konkurens megoldásokra. A bevezetési promóció keretében 50 százalékos kedvezménnyel érhető el a rendszer: 1 millió bemeneti token ára 2 dollár, a kimeneti tokeneké pedig 10 dollár. Ez a gyakorlatban tovább mélyíti a Claude Opus 5.5 által indított modellpiaci árháborút. A promóciós időszak lezárulása után a díjszabás 4 és 20 dollárra módosul majd.
Belső mérnöki kételyek és szövetségi biztonsági vizsgálat
A hivatalos bejelentés részleteit Sundar Pichai a közösségi médiában, egy részletes X-bejegyzésben tette közzé, bemutatva a modell harcra foghatóságát:
A kiemelkedő szintetikus teszteredmények ellenére belső kritikák is érték a projektet. A Bloomberg belső forrásokra hivatkozó riportja szerint a vállalat egyes szoftvermérnökei szkepticizmusuknak adtak hangot: megfigyeléseik alapján a modell a valós gyártási környezetben futtatott összetett feladatoknál váratlan szintaktikai hibákat és logikai elakadásokat mutat. A laboratóriumi benchmarkok és a mindennapi kódolási stabilitás közötti rés áthidalása további finomhangolást igényel.
A szélesebb körű publikus és vállalati elterjedést jelenleg kormányzati auditok szabályozzák. Az amerikai mesterséges intelligencia biztonsági intézet (US AI Safety Institute) szigorú kiberbiztonsági vizsgálatnak veti alá a súlyokat. A szakemberek kiemelt figyelmet fordítanak a prompt-injection behatolások elleni védelemre, hogy megelőzzék a szoftveres homokozókból kitörő autonóm AI-ágensek kockázatait. A rendszer a jóváhagyási folyamat lezárulta után kaphat teljes zöld utat a felhős infrastruktúrákban.