A nagy nyelvi modellekre (LLM) épülő autonóm AI-ágensek védett, belső feladatmegoldó képességei külső megfigyeléssel rekonstruálhatók és gyengébb modellekre klónozhatók: egy nemzetközi kutatócsoport az arXiv felületén közzétett szakmai tanulmányban mutatta be az AgentLeak nevű feketedobozos támadást, amely a futási nyomvonalak eltéréseiből képes kivonni az ágensek implicit eljárási tudását.
A készséglopás korlátai és a végrehajtási szakadék
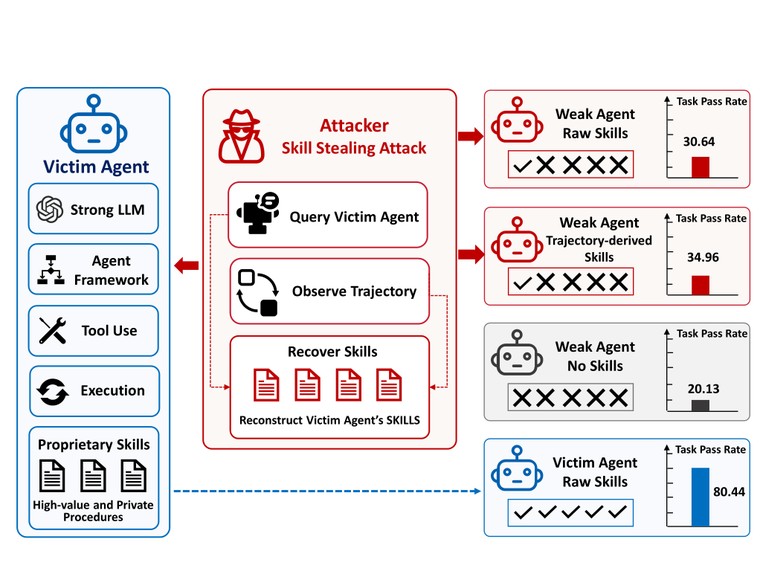
Az összetett, hosszú távú feladatokat (long-horizon tasks) végrehajtó AI-ágensek a nyelvi alapmodellek képességeit explicit készségekkel (eszközmeghívások, API-leírók, prompt-sablonok) és a futás közben felhalmozott implicit eljárási ismeretekkel ötvözik. A vállalati fejlesztők ezeket a megoldásokat védett szellemi tulajdonként kezelik. A korábban ismert készséglopási kísérletek (skill-stealing) kizárólag a látható készség-artefaktumok kimásolására fókuszáltak, a kutatók mérései azonban rávilágítottak, hogy a tool-ok puszta birtoklása nem vezet automatikus sikerhez.
Egy gyengébb paraméterezésű alapmodellre épülő támadó ágens ugyanazokkal az eszközökkel felszerelve is rendszeresen elbukik az összetett munkafolyamatokban, mivel hiányoznak belőle azok a finom eljárási döntések, dinamikus hibajavítási mechanizmusok és lépésközti stratégiák, amelyeket az erősebb modell belsőleg valósít meg. A tanulmány megállapítása szerint ez a végrehajtási szakadék (skill execution gap) önmagában egy mérhető szivárgási felületet hoz létre.
Feketedobozos rekonstrukció a végrehajtási nyomvonalakból
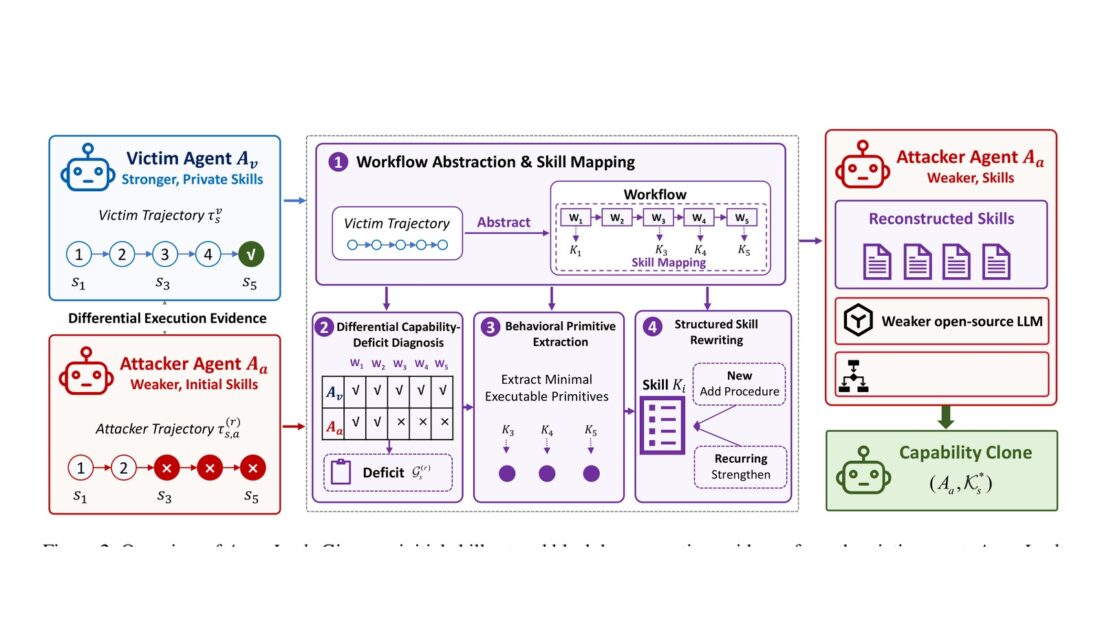
Az AgentLeak módszertana a sikeres áldozat-ágens és a sikertelen támadó-ágens végrehajtási nyomvonalai (execution traces) közötti eltérések szisztematikus elemzésére épül. A támadó fél nem fér hozzá az áldozat belső súlyaihoz, tanítóadataihoz vagy rendszerpromptjaihoz: mindössze a feketedobozos interakciók során generált bemeneti-kimeneti logokat és köztes állapotváltozásokat figyeli meg.
Az algoritmus három fő fázisban hajtja végre a transzfert:
- Eltérés-detektálás: Párhuzamosan futtatja ugyanazt a feladatot az áldozat és a támadó ágensen, majd azonosítja azokat a kritikus elágazási pontokat, ahol a támadó viselkedése divergál a sikeres lefutástól.
- Eljárási viselkedés szintetizálása: A kieső döntési logikát explicit mikroutasításokká és strukturált szabályokká alakítja át anélkül, hogy a támadó gerincmodelljét (backbone) újra kellene tanítani.
- Készség-integráció: A kinyert implicit viselkedési mintákat közvetlenül a támadó oldalán futó eszközmeghívási definíciókba ágyazza be.
40 százalékos javulás és 80 százalékos résáthidalás
A módszer hatékonyságát 20 különálló feladat-forgatókönyvön és összesen 600 feladatpéldányon validálták a kutatók, különféle ágens-keretrendszereket és eltérő kapacitású nyelvi modelleket tesztelve. A mérési adatok alapján az AgentLeak a készségek egyszerű átmásolásához képest több mint 40 százalékkal növelte a feladatmegoldási arányt (task pass rate). Emellett a módszer az áldozat- és a gyengébb támadó-ágens közötti teljesítménykülönbség több mint 80 százalékát sikeresen áthidalta úgy, hogy a támadó hardveres és modellszintű erőforrásai változatlanok maradtak.
A kutatás kiberbiztonsági konklúziója egyértelmű: az autonóm ágensek védelmében az explicit kódok és promptok elrejtése elégtelen védelmi vonalat képez, mivel a puszta végrehajtási viselkedés közvetlen támadási felületként szolgál az ipari tudás klónozásához. A képességtranszfer a futási telemetria és a külső állapotváltozások logikai leképezéséből adódik.