A Twitch hivatalos súgója szerint a streamerek külön kapcsolóval tilthatják le, hogy csatornájuk tartalma generatív AI-modellek tanításában részt vegyen. Közben a Law360 beszámolója szerint egy kaliforniai streamer javasolt csoportos keresetet nyújtott be a Twitch és az Amazon ellen, azt állítva, hogy a cégek engedély és ellentételezés nélkül használták fel a közvetítéseket AI-tréningre.
A kereset állítása szerint nem csak az élő adások érintettek: a VOD-ok, a klipek, a streamchatek, valamint a csatornán megjelenő képek és szövegek is bekerülhetnek a generatív modellek tanítására használható körbe. Ez nem bírósági megállapítás, hanem a felperes jogi álláspontja; az ügy kimenetele és az, hogy pontosan milyen adatokat használtak, még nem dőlt el.
A kapcsoló alapból be van kapcsolva
A Twitch-fiók biztonsági és adatvédelmi beállításai között szereplő „Training for Generative AI” opció alapértelmezés szerint engedélyezi a csatornatartalom jövőbeli felhasználását az Amazon generatív AI-modelljeihez. Aki ezt kikapcsolja, annál a Twitch szerint a jövőbeni tréningből kimaradnak a streamek, VOD-ok, klipek, chatek, képek és szövegek.
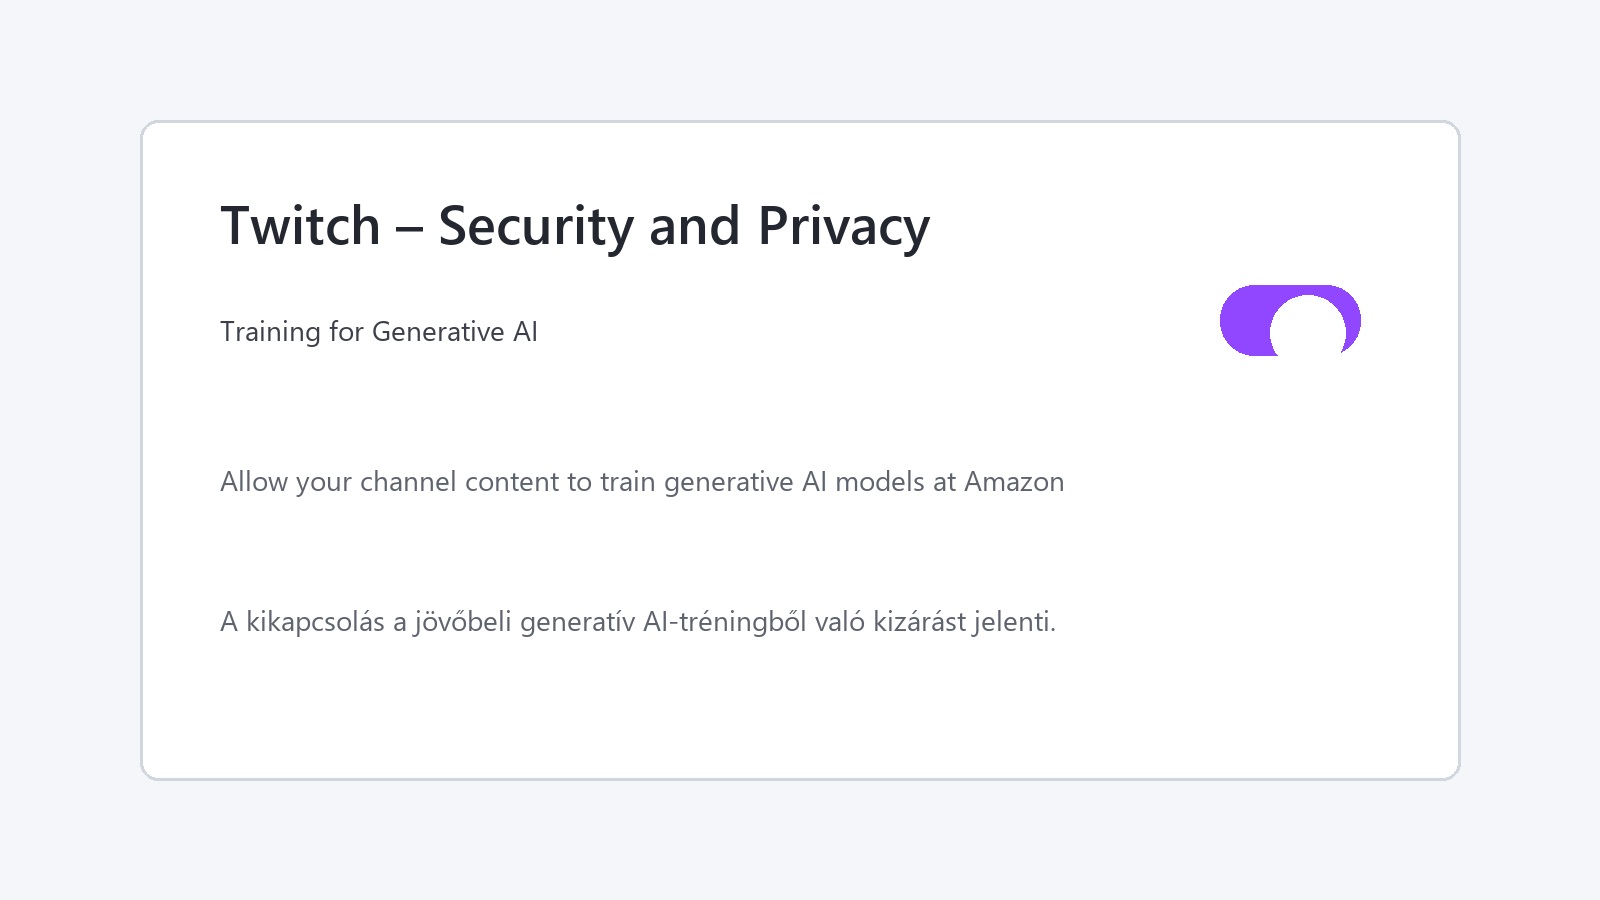
A tiltás nem jelent teljes kivonulást minden AI-funkcióból. A Twitch külön kezeli a generatív modellek tanítását és az olyan szolgáltatásokat, mint az automatikus feliratozás, az ajánlórendszer vagy az AutoMod. A hivatalos FAQ szerint ezek egy része továbbra is működhet, mert nem feltétlenül őrzi meg a tartalmat új videó-, kép- vagy szöveggeneráló modellek tanítására.
A vita egyik legfontosabb kérdése ezért nem az, hogy egy platform használ-e gépi tanulást, hanem hogy mire kapott engedélyt, mikor tájékoztatta erről a felhasználókat, és mi történik a korábban begyűjtött anyagokkal. A Twitch jelenlegi kapcsolója a jövőbeni tréningre vonatkozik; abból nem következik, hogy a korábbi felhasználás automatikusan visszafordul.